Speculative Decoding (spekulatives Dekodieren) ist eine Technik, um ein großes Sprachmodell zu beschleunigen: Ein kleines Draft-Modell errät die nächsten Token, und das große Modell prüft sie alle in einem einzigen Durchlauf. Dabei behält es nur die Token, die es selbst erzeugt hätte.
Die Methode stammt aus zwei Forschungsarbeiten. Google Research gab ihr den Namen in Fast Inference from Transformers via Speculative Decoding (Leviathan, Kalman und Matias, erstmals veröffentlicht im November 2022). DeepMind beschrieb eine eigene, unabhängig entwickelte Variante in Accelerating Large Language Model Decoding with Speculative Sampling (Chen und Kollegen, Februar 2023).
Warum ist das Standard-Decoding langsam?
Das Standard-Decoding ist langsam, weil ein großes Sprachmodell ein Token nach dem anderen schreibt und jedes Token einen vollständigen Durchlauf des Modells erfordert. Das Google-Paper bringt es auf den Punkt: „Das Dekodieren von K Token erfordert K aufeinanderfolgende Durchläufe des Modells“.
Viele dieser Token sind leicht vorherzusagen. Dasselbe Paper stellt fest, dass „schwierige Sprachmodellierungsaufgaben oft einfachere Teilaufgaben enthalten, die sich durch effizientere Modelle gut annähern lassen“.
Wie arbeiten das Draft-Modell und das vollständige Modell zusammen?
Die beiden Modelle arbeiten in Runden, und jede Runde besteht aus drei Schritten:
- Entwurf. Das kleine Modell schreibt eine kurze Folge von Vermutungen, ein Token nach dem anderen. Das Google-Paper nennt es Approximationsmodell, DeepMind nennt es Draft-Modell.
- Prüfung. Das große Modell, das sogenannte Zielmodell, bewertet jede vermutete Position parallel in einem einzigen Durchlauf.
- Annehmen oder korrigieren. Die Vermutungen werden von links nach rechts angenommen. Bei der ersten abgelehnten Vermutung liefert das große Modell sein eigenes Token, und die nachfolgenden Vermutungen werden verworfen. Werden alle Vermutungen angenommen, ergänzt das große Modell ein weiteres Token.
Jeder Durchlauf des großen Modells liefert mindestens ein Token und höchstens die Anzahl der Vermutungen plus eins. Es sind also nie mehr Durchläufe nötig als beim Standard-Decoding.
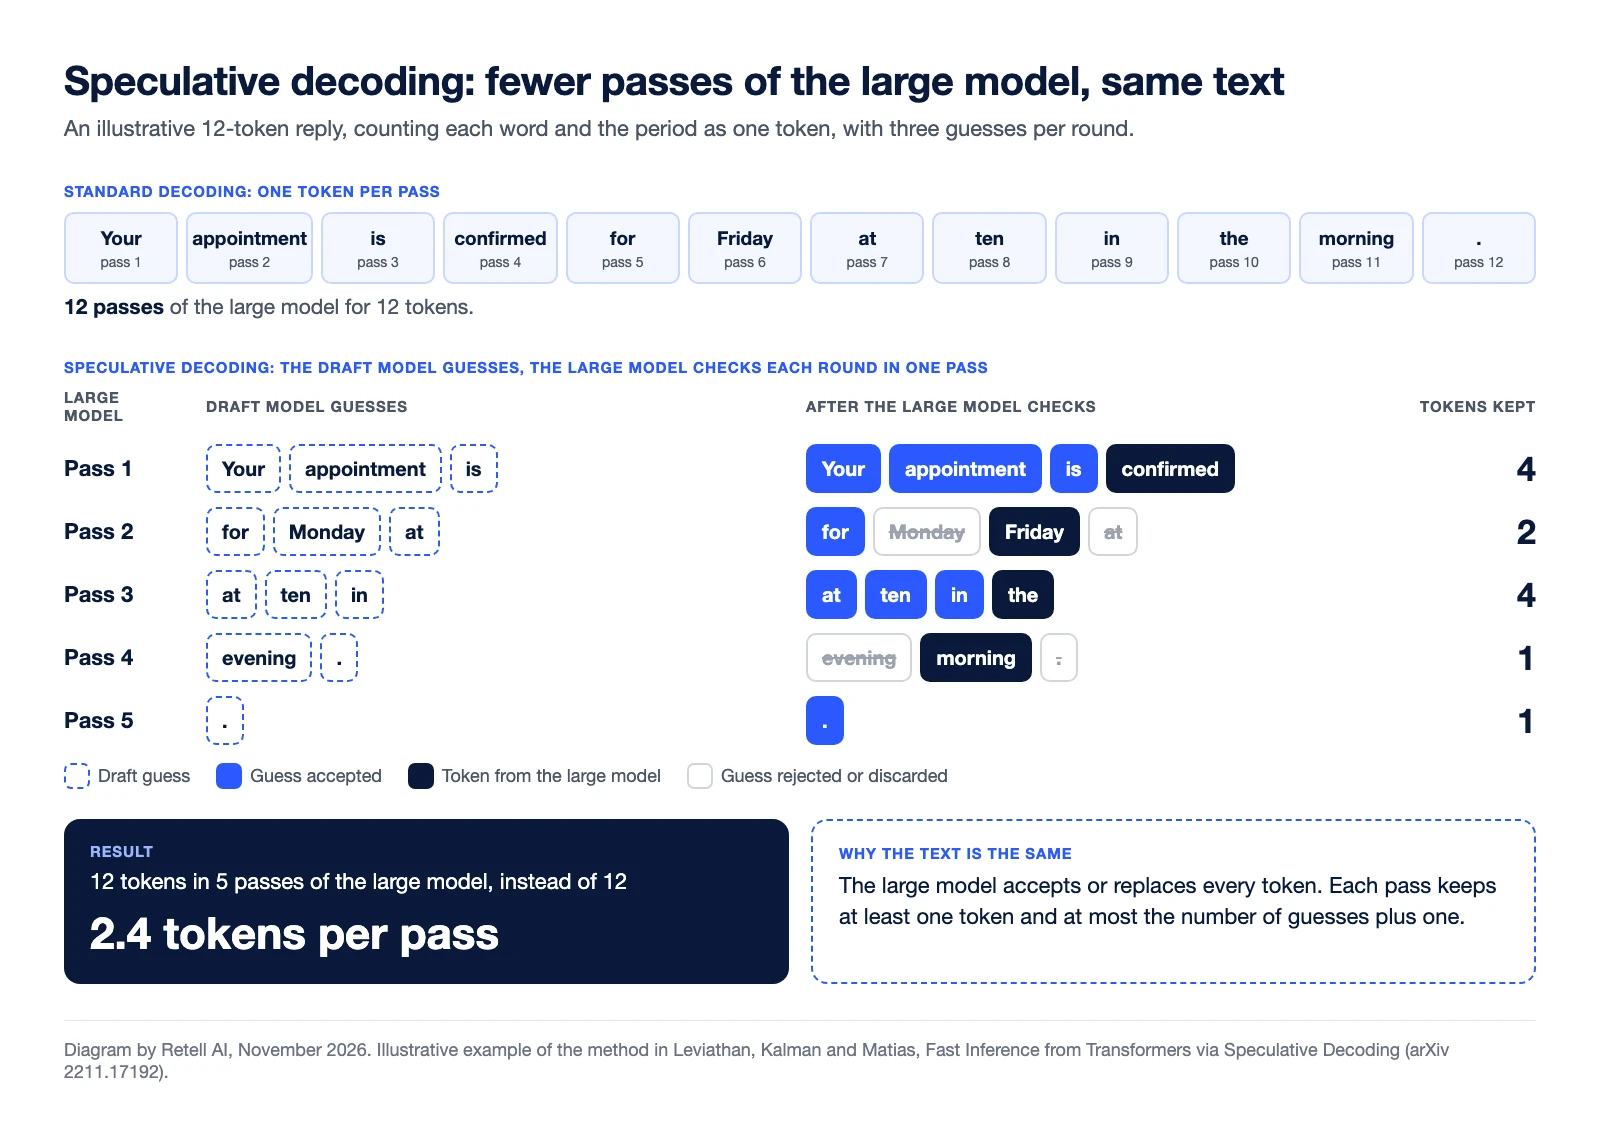
Rechenbeispiel (zur Veranschaulichung). Eine englische Antwort mit 12 Token, wobei jedes Wort und der Punkt als ein Token zählen, mit drei Vermutungen pro Runde:
| Durchlauf des großen Modells | Vermutungen des Draft-Modells | Urteil des großen Modells | Behaltene Token |
|---|---|---|---|
| 1 | Your appointment is | Alle drei angenommen, ergänzt „confirmed“ | 4 |
| 2 | for Monday at | „for“ angenommen. „Monday“ abgelehnt und durch „Friday“ ersetzt. „at“ verworfen | 2 |
| 3 | at ten in | Alle drei angenommen, ergänzt „the“ | 4 |
| 4 | evening . | „evening“ abgelehnt und durch „morning“ ersetzt. Der Punkt wird verworfen | 1 |
| 5 | . | Angenommen, und die Antwort endet | 1 |
| Gesamt | 12 Token in 5 Durchläufen |
Beim Standard-Decoding braucht das große Modell für diesen Satz 12 Durchläufe. Hier läuft es nur 5-mal, im Schnitt also 2,4 Token pro Durchlauf.
Warum bleibt die Ausgabe unverändert?
Die Ausgabe bleibt unverändert, weil das große Modell bei jedem Token das letzte Wort hat. Beim Greedy Decoding, bei dem das Modell immer seine erste Wahl nimmt, wird eine Vermutung nur behalten, wenn sie genau das Token ist, das auch das große Modell gewählt hätte. Die vLLM-Dokumentation nennt einen Test genau dafür: Greedy Sampling mit Speculative Decoding „stimmt mit Greedy Sampling ohne Speculative Decoding überein“.
Beim zufälligen Sampling wird eine Vermutung mit einer Wahrscheinlichkeit angenommen, die davon abhängt, wie die beiden Modelle sie bewerten. Eine abgelehnte Vermutung wird aus einer angepassten Verteilung neu gezogen. Das Google-Paper beweist, dass die Ausgabeverteilung dadurch unverändert bleibt. DeepMind formuliert es so, dass das Verfahren „die Verteilung des Zielmodells im Rahmen der Hardware-Numerik erhält“.
Einige neuere Varianten lockern die Prüfung bewusst, um mehr Geschwindigkeit zu gewinnen. vLLM weist darauf hin, dass eine seiner Verifizierungsmethoden „nicht verteilungserhaltend“ ist.
Wann hilft Speculative Decoding und wann nicht?
Speculative Decoding hilft, wenn das Draft-Modell günstig ist und meist richtig liegt und der Server über freie Rechenkapazität verfügt.
| Bedingung | Auswirkung auf die Geschwindigkeit | Quelle |
|---|---|---|
| Vermutungen werden meist angenommen | Mehr Token pro Durchlauf. Erwartete Token pro Durchlauf = (1 − α^(γ+1)) ÷ (1 − α), wobei α die Annahmerate und γ die Anzahl der Vermutungen pro Runde ist | Google-Paper |
| Draft-Modell ist deutlich kleiner als das Zielmodell | Geringe Entwurfskosten. Ein Draft-Modell, das etwa zwei Größenordnungen kleiner ist, „schnitt in der Regel am besten ab“ | Google-Paper |
| Freie Rechenkapazität ist vorhanden | Erforderlich. Die Methode setzt „genügend Rechenressourcen zur Unterstützung der erhöhten Parallelität“ voraus | Google-Paper |
| Hohe Last auf dem Server | Geringerer Gewinn. vLLM bewertet ein Draft-Modell bei niedrigen Anfrageraten mit „hohem Gewinn“ und bei hohen mit „mittlerem Gewinn“ | vLLM-Dokumentation |
| Draft-Modell liegt gemessen an seinen Kosten zu oft falsch | Kein Gewinn. Eine Beschleunigung gibt es nur, wenn die Annahmerate höher ist als die Kosten des Draft-Modells im Verhältnis zum Zielmodell | Google-Paper |
Zur Veranschaulichung: Eine Annahmerate von 0,6 bei drei Vermutungen pro Runde ergibt etwa 2,2 Token pro Durchlauf.
Veröffentlichte Beschleunigungen: Das Google-Paper berichtet das 2- bis 3-Fache bei einem T5-XXL-Modell mit 11 Milliarden Parametern. DeepMind berichtet das 2- bis 2,5-Fache beim Chinchilla-Modell mit 70 Milliarden Parametern und einem Draft-Modell mit 4 Milliarden Parametern. Die Ergebnisse hängen von den Modellen, der Aufgabe und der Hardware ab.
Ein Praxisbeispiel aus dem Sprachbereich: Tell-1, das eigene LLM von Retell, nutzt Speculative Decoding, um aus jedem Durchlauf des vollständigen Modells etwa vier Token zu gewinnen, wie der technische Beitrag von Retell zum Retell LLM beschreibt.
Warum ist Speculative Decoding für Echtzeit-Sprache wichtig?
Speculative Decoding ist für Echtzeit-Sprache wichtig, weil Anrufende die Rechenzeit des Modells als Stille wahrnehmen. In einem Anruf ist das Modell eine Stufe der Pipeline aus Speech-to-Text, LLM und Text-to-Speech, und seine Verzögerung erhöht die Latenz des Anrufs.
Die Best Practices für benutzerdefinierte LLMs von Retell erklären, welcher Teil der Modellzeit zählt: Retell „beginnt zu sprechen, sobald der erste vollständige Satz vorliegt“. Entscheidend ist also die „Zeit bis zum ersten Token plus die Zeit bis zum Abschluss dieses ersten Satzes“. Speculative Decoding wirkt auf den zweiten Teil: Sobald die Generierung beginnt, kommen die Token in Gruppen an. Das Einlesen des Prompts vor dem ersten Token wird dadurch nicht kürzer. Dafür setzt der Leitfaden zur Latenz-Fehlerbehebung von Retell bei der Modellwahl und der Prompt-Länge an.
Der andere Grund ist die Genauigkeit. Der Wechsel zu einem kleineren Modell verringert ebenfalls die Verzögerung, doch derselbe Leitfaden warnt, dass ein Modellwechsel „das Verhalten Ihres Agenten verändert, nicht nur seine Geschwindigkeit“. Exaktes Speculative Decoding erhält die Ausgabe des großen Modells.
Angewendet wird es vom Anbieter, der das Modell bereitstellt. Wer einen Agenten entwickelt, nimmt es daher als Modellgeschwindigkeit wahr. Bei Retell wird Tell-1 auf diese Weise bereitgestellt. Einen Vergleich von Modellen nach Geschwindigkeit und Anrufqualität finden Sie unter die besten LLMs für KI-Sprachagenten.
Häufig gestellte Fragen zu Speculative Decoding
Ist Speculative Decoding verlustfrei?
In seiner exakten Form ja. Die ursprünglichen Paper beweisen, dass die Ausgabeverteilung der des großen Modells entspricht, und vLLM beschreibt es als „theoretisch verlustfrei bis zu den Genauigkeitsgrenzen der Hardware-Numerik“. Varianten mit gelockerter Verifizierung sind nicht verlustfrei.
Wer hat Speculative Decoding entwickelt?
Yaniv Leviathan, Matan Kalman und Yossi Matias von Google Research veröffentlichten das Paper im November 2022 und stellten es auf der ICML 2023 vor. Ein Team von DeepMind veröffentlichte im Februar 2023 eine eigene Variante namens Speculative Sampling.
Was ist ein Draft-Modell?
Ein Draft-Modell ist das kleine, schnelle Modell, das die Vermutungen schreibt. Laut der Dokumentation von Hugging Face funktioniert die Methode am besten, wenn es „deutlich kleiner als das Hauptmodell ist und denselben Tokenizer verwendet“.
Senkt Speculative Decoding die Kosten?
Das kann in beide Richtungen gehen. Das Google-Paper merkt an, dass die Gesamtzahl der Rechenoperationen „höher sein kann als beim Standard-Decoding-Algorithmus“, da abgelehnte Vermutungen verschwendete Arbeit sind. Googles Rückblick aus dem Jahr 2024 ergänzt, dass schnellere Ergebnisse auf derselben Hardware bedeuten, dass „weniger Maschinen benötigt werden, um dieselbe Menge an Traffic zu bedienen“.
Ist Multi-Token-Prediction dasselbe wie Speculative Decoding?
Nein. Multi-Token-Prediction (MTP) ist eine Möglichkeit, die Vermutungen zu erzeugen. Die vLLM-Dokumentation führt MTP neben Draft-Modellen als Spekulationsmethode auf.
Testen Sie die Modellgeschwindigkeit mit Ihren eigenen Anrufen
Die Retell AI ist eine Plattform für KI-Sprachagenten für Contact Center. Sprechen Sie mit dem Retell-Team über ein Pilotprojekt mit echten Anrufen.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


