SSML (Speech Synthesis Markup Language) ist eine XML-basierte Auszeichnungssprache, die einer Text-to-Speech-Engine mitteilt, wie sie einen Text sprechen soll: wo sie pausiert, wie ein Wort ausgesprochen wird, wie eine Zahl oder ein Datum gelesen wird und wie schnell, laut oder hoch gesprochen wird. Die Engine liest die Tags als Anweisungen und spricht sie nicht aus.
SSML ist ein Standard des World Wide Web Consortium (W3C). Die aktuelle Version, SSML 1.1, wurde am 7. September 2010 zur W3C-Empfehlung und wurde von der Voice Browser Working Group des W3C erarbeitet. Laut Spezifikation soll sie Autorinnen und Autoren „eine standardisierte Möglichkeit bieten, Aspekte der Sprache wie Aussprache, Lautstärke, Tonhöhe, Sprechgeschwindigkeit usw. über verschiedene synthesefähige Plattformen hinweg zu steuern“.
Wie sieht SSML aus?
Ein SSML-Dokument ist XML mit einem einzigen Wurzelelement, <speak>. Dieses kurze Beispiel ist gültiges SSML 1.1:
<speak version="1.1" xmlns="http://www.w3.org/2001/10/synthesis" xml:lang="en-US">
  Your code is <say-as interpret-as="characters">B7X4</say-as>.
  <break time="400ms"/>
  It ships to <phoneme alphabet="ipa" ph="ˌmænɪˈtoʊbə">Manitoba</phoneme>
  on <say-as interpret-as="date" format="yyyymmdd" detail="1">2026-11-19</say-as>.
  Questions go to <sub alias="Doctor">Dr.</sub> Lee.
</speak>
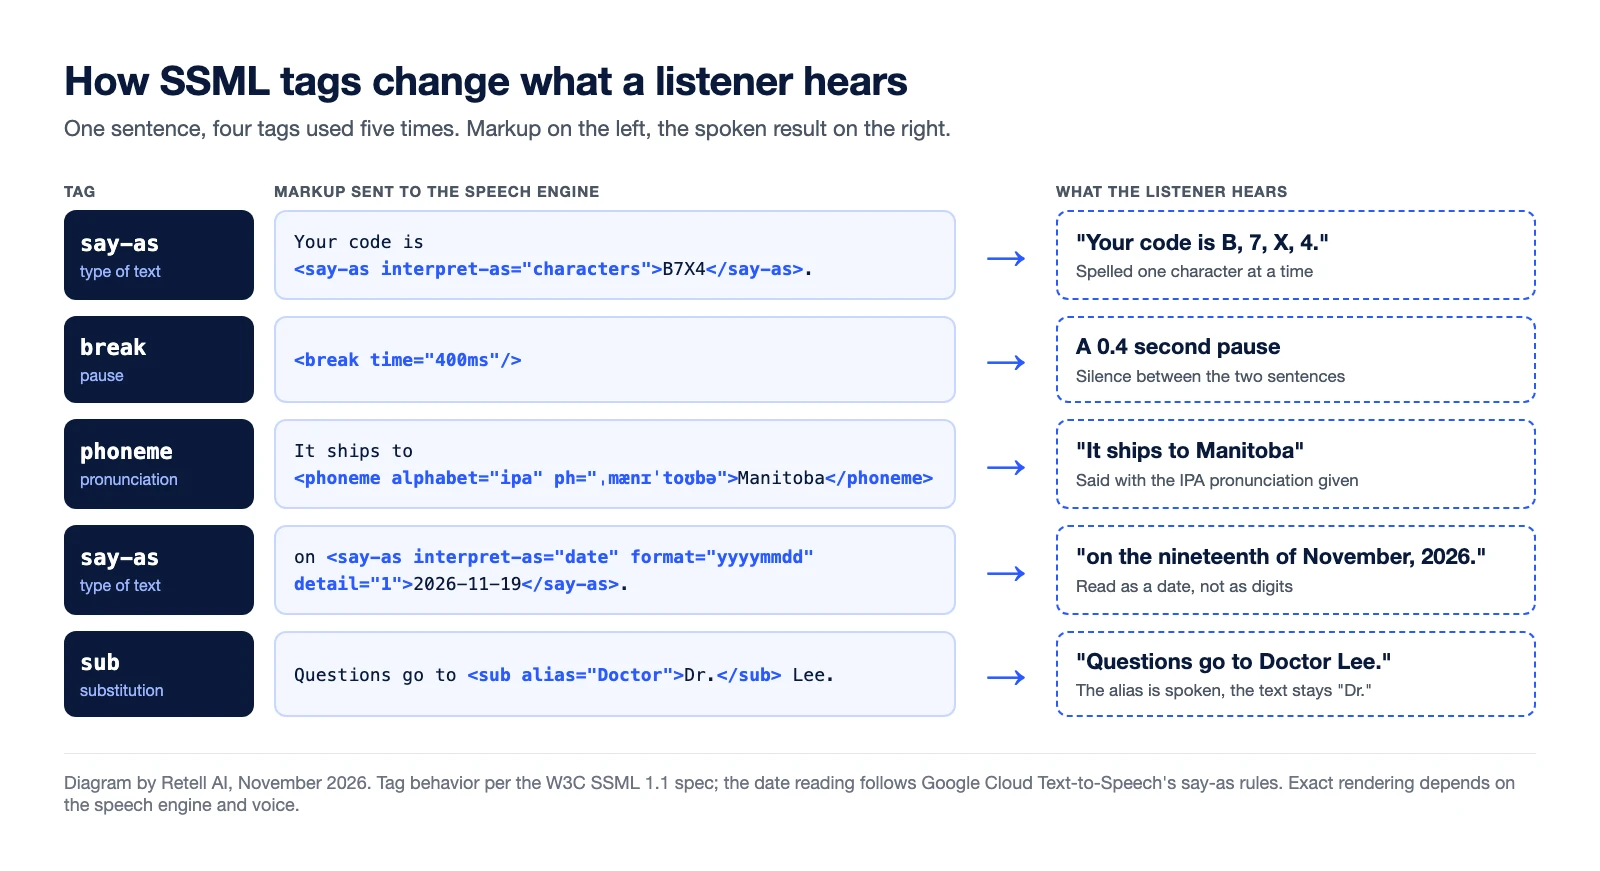
Die Abbildung zeigt, was Zuhörende bei jedem Tag hören, sofern die Engine es unterstützt.
Welches sind die gängigsten SSML-Tags?
Die Beschreibungen folgen der W3C-Spezifikation.
| Tag | Funktion | Beispiel |
|---|---|---|
<speak> | Wurzelelement jedes SSML-Dokuments. In SSML 1.1 sind die Attribute version und xml:lang sowie der SSML-Namespace erforderlich. | <speak version="1.1" xml:lang="en-US"> |
<break> | Fügt eine Pause oder prosodische Grenze ein, festgelegt über strength (none bis x-strong) oder über time. | <break time="400ms"/> |
<say-as> | Teilt der Engine mit, welche Art von Text sie liest, etwa ein Datum, eine Uhrzeit, eine Zahl oder einen Geldbetrag. | <say-as interpret-as="characters">B7X4</say-as> |
<phoneme> | Gibt eine phonetische Aussprache für den eingeschlossenen Text an. Laut Spezifikation sollten Engines das Alphabet ipa unterstützen. | <phoneme alphabet="ipa" ph="..."> |
<sub> | Spricht den Wert von alias anstelle des geschriebenen Texts. | <sub alias="Doctor">Dr.</sub> |
<prosody> | Ändert Tonhöhe, Sprechgeschwindigkeit und Lautstärke des eingeschlossenen Texts. | <prosody rate="slow"> |
<emphasis> | Fordert eine Betonung eines Worts oder einer Phrase an, mit einem level von strong, moderate, none oder reduced. | <emphasis level="strong"> |
Zwei Details der Spezifikation erklären, warum die Ergebnisse variieren. Erstens definiert sie <say-as>, „zählt jedoch die möglichen Werte für die Attribute nicht auf“, sodass jeder Anbieter seine eigene Liste von interpret-as-Werten festlegt. Zweitens bezeichnet sie Prosodiewerte als „indikativ“ und überlässt es der Engine, wie Betonung wiedergegeben wird.
Wo unterscheidet sich die SSML-Unterstützung zwischen Sprach-Engines?
Jede Engine implementiert ihre eigene Teilmenge, und neuere Stimmmodelle unterstützen oft weniger Markup als ältere. Laut der Dokumentation der jeweiligen Anbieter, abgerufen am 13. November 2026:
- Google Cloud Text-to-Speech unterstützt „eine Teilmenge der verfügbaren SSML-Tags“. Die Chirp 3: HD-Stimmen akzeptieren zehn Tags ohne
<emphasis>, andere Tags „werden ignoriert“, und Streaming-Anfragen akzeptieren kein SSML. - Amazon Polly listet die Tag-Unterstützung nach Stimmtyp auf.
<emphasis>ist für neuronale, Long-Form- und generative Stimmen nicht verfügbar, und ein nicht unterstütztes Tag gibt bei Standard-, neuronalen oder Long-Form-Stimmen einen Fehler zurück. - Azure AI Speech stützt seine Implementierung auf SSML 1.0 und gibt an, dass die unterstützten Elemente „vom W3C-Standard abweichen können“. Es ergänzt eigene
mstts-Elemente für Sprechstile, und Betonung auf Wortebene funktioniert bei drei benannten englischen Stimmen. - ElevenLabs unterstützt zwei SSML-Tags bei einigen Modellen:
<break>für Pausen bis zu 3 Sekunden und<phoneme>nur bei Flash v2. Eleven v3 und v4 unterstützen keine break-Tags. - Cartesia Sonic dokumentiert eigene „SSML-ähnliche“ Tags: speed, volume, emotion, break und spell.
Dasselbe Dokument kann von einer Engine umgesetzt, von einer anderen stillschweigend ignoriert und von einer dritten abgelehnt werden. Testen Sie das Markup mit genau der Stimme und dem Modell, die Sie einsetzen werden.
Warum ist SSML für Sprachagenten wichtig?
Anrufende können den Text nicht sehen. Bei Sprach-KI kostet eine falsche Lesart eine Wiederholung oder einen fehlerhaften Datensatz:
- Namen. Aussprachen von Marken, Medikamenten und Nachnamen, die die Stimme falsch errät.
- Zahlen. Ein Bestätigungscode, der als ein Wort gelesen wird, oder eine Kontonummer, die als Menge gelesen wird.
- Datum und Uhrzeit. Ein Datum wie 11/19, das als zwei separate Zahlen gelesen wird.
- Pausen. Zeit, um jede Zifferngruppe einer Telefonnummer zu notieren.
SSML eignet sich für geskriptete Ansagen, bei denen Entwickler jede Zeile einmal mit Tags versehen. Das passt zu einem IVR-Menü. Zu einem live agierenden KI-Sprachagenten passt es weniger gut.
Wie gehen LLM-gesteuerte Sprachagenten ohne SSML mit der Aussprache um?
Bei einem LLM-gesteuerten Agenten schreibt ein Large Language Model jede Antwort während des Anrufs, und der Text wird noch während der Generierung an die Sprach-Engine gestreamt (so funktioniert die STT-, LLM- und TTS-Pipeline). Niemand versieht Sätze manuell mit Tags, und Streaming bringt einen Haken mit sich: Die Dokumentation von Cartesia warnt, dass ein speed- oder volume-Tag, das über gestreamte Tokens hinweg aufgeteilt wird, laut vorgelesen wird. Teams nutzen stattdessen vier Methoden:
- Prompts für sprechbaren Text. Weisen Sie das Modell an, „vier eins fünf“ statt „415“ zu schreiben.
- Textnormalisierung. Ein Schritt vor der Synthese wandelt Zahlen, Datumsangaben und Währungsbeträge in gesprochene Form um.
- Ein Aussprachewörterbuch. Eine Wortliste mit phonetischen Schreibweisen, die auf jede Antwort angewendet wird.
- Sprachsteuerung der Plattform. Inline-Marker, die die Plattform für jeden Stimmanbieter übersetzt.
Wie steuert die Retell AI Pausen und Aussprache?
Die Dokumentation der Retell AI beschreibt keine direkte SSML-Eingabe. Sie dokumentiert folgende Steuerungen:
- Pausen und Buchstabieren. Laut der Dokumentation zu Speech Controls fügt ein Gedankenstrich mit je einem Leerzeichen davor und danach eine Pause ein, und
<spell>-Tags lesen einen Code oder eine Kontonummer Zeichen für Zeichen vor. Retell wandelt das Tag „in das Format um, das für die Stimme Ihres Agenten am besten funktioniert“. - Aussprachewörterbuch. Einträge bestehen aus einem Wort und einem Phonem in IPA, CMU, Pinyin oder Jyutping. Stimmen der Retell-Plattform akzeptieren IPA und CMU, einige Anbietermodelle keines davon.
- Speech Normalization. Eine standardmäßig deaktivierte Voreinstellung im Agent Handbook, die Zahlen, Datumsangaben, Geldbeträge und Telefonnummern in gesprochene Form bringt.
Siehe auch: wie KI-Sprachagenten bei einem Anruf funktionieren.
Häufig gestellte Fragen zu SSML
Wofür wird SSML verwendet?
Es steuert, wie eine Text-to-Speech-Engine Text vorliest: Pausen, Aussprache, das Lesen von Zahlen und Datumsangaben sowie Tonhöhe, Sprechgeschwindigkeit und Lautstärke.
Ist SSML bei jeder Text-to-Speech-Engine gleich?
Nein. Jede Engine unterstützt ihre eigene Teilmenge der W3C-Spezifikation und ergänzt eigene Tags, sodass Markup zwischen Engines oft angepasst werden muss.
Unterstützt ElevenLabs SSML?
Teilweise. Die Dokumentation beschreibt break-Tags für Pausen bis zu 3 Sekunden und phoneme-Tags beim Modell Flash v2. Eleven v3 und v4 unterstützen keine break-Tags (Stand: November 2026).
Was ist der Unterschied zwischen SSML und einem Aussprachewörterbuch?
SSML-Tags stehen innerhalb eines bestimmten Texts und gelten nur dort. Ein Aussprachewörterbuch ist eine separate Wortliste, die die Engine oder Plattform auf jedes passende Wort anwendet.
Nutzen KI-Sprachagenten SSML?
Manche ja, sofern die Sprach-Engine es akzeptiert. Viele setzen auf Prompting, Textnormalisierung und Aussprachewörterbücher, weil Antworten live generiert werden und einige neuere Stimmmodelle kaum SSML akzeptieren.
Damit jeder Name und jede Zahl richtig klingt
Die Retell AI ist eine Plattform für KI-Sprachagenten für Contact Center. Sie können Pausen, Buchstabieren und Aussprache für jeden Agenten steuern und das Ergebnis in einem Webanruf-Test anhören. Sprechen Sie mit dem Retell-Team.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


