LLM als Richter (LLM-as-a-Judge) ist eine Evaluierungsmethode, bei der ein Large Language Model die Ausgabe eines anderen KI-Systems anhand schriftlicher Kriterien bewertet oder in eine Rangfolge bringt – anstelle eines menschlichen Prüfers. Teams nutzen die Methode, um offene Aufgaben ohne eindeutig richtige Antwort zu bewerten, etwa ein Telefongespräch.
Der Name geht auf ein Paper aus dem Jahr 2023 zurück: Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Die Autoren berichteten, dass starke Richtermodelle wie GPT-4 mit menschlichen Präferenzen „zu über 80 % übereinstimmten – genauso häufig, wie Menschen untereinander übereinstimmen“. Zugleich nannten sie die Grenzen: Positions-, Ausführlichkeits- und Selbstbevorzugungs-Bias.
Wie bewertet ein LLM-Richter ein Gespräch?
Ein LLM-Richter liest das Gespräch und eine Reihe von Anweisungen und gibt dann ein Urteil in einer von drei Formen zurück.
| Methode | Was der Richter tut | Was zurückkommt | Wofür sie geeignet ist |
|---|---|---|---|
| Rubrik-Bewertung | Prüft ein Transkript anhand schriftlicher Kriterien | Bestanden oder nicht bestanden bzw. ein Score, jeweils mit Begründung | QA im Produktivbetrieb und Regressionstests |
| Paarweises Ranking | Vergleicht zwei oder mehr Antworten auf denselben Gesprächsschritt | Einen Gewinner oder eine Rangfolge | Auswahl zwischen Prompts oder Modellen |
| Richtergremium | Mehrere Richtermodelle bewerten dasselbe Element, die Urteile werden zusammengeführt | Ein zusammengeführter Score | Scores, die der Bias eines einzelnen Modells verzerren könnte |
Rubrik-Bewertung. Im G-Eval-Paper ging der Richter die Kriterien Schritt für Schritt durch und füllte anschließend ein Bewertungsformular aus. Bei Zusammenfassungen korrelierten seine Scores besser mit menschlichen Bewertungen als frühere Methoden.
Paarweises Ranking. Die Frage, welche von zwei Antworten besser ist, eignet sich für Eigenschaften wie den Tonfall, bei denen ein Unterschied leichter zu erkennen als zu bewerten ist.
Richtergremien. In Replacing Judges with Juries „übertrifft“ ein Gremium kleinerer Modelle aus verschiedenen Modellfamilien „einen einzelnen großen Richter, weist weniger modellinternen Bias auf“ und war „mehr als siebenmal günstiger“.
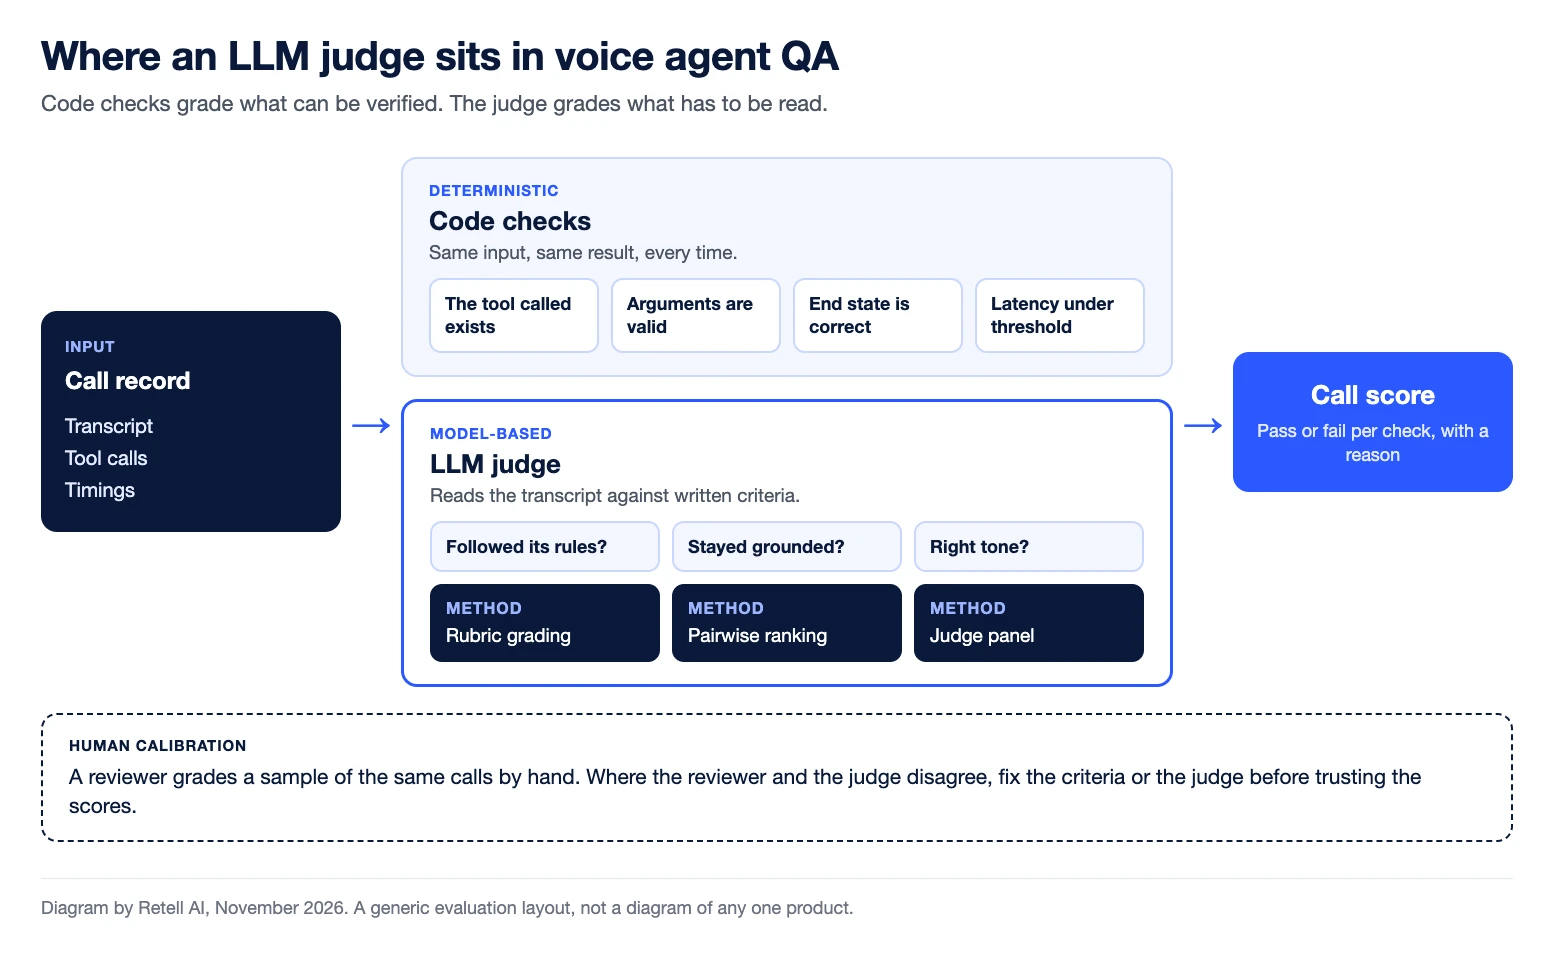
Wie wird LLM als Richter bei der QA von Sprachagenten und in Benchmarks eingesetzt?
Bei der QA von Sprachagenten kommt ein LLM-Richter für die Teile eines Anrufs zum Einsatz, die sich nur durch Lesen des Transkripts beurteilen lassen: ob der Agent seine Regeln befolgt hat, bei seinen Quellen geblieben ist und das Anliegen gelöst hat.
Die Dokumentation von Retell zeigt beide gängigen Setups. In AI QA ist eine KI-bewertete Bedingung „eine qualitative Prüfung, die die KI anhand des Transkripts und Kontexts jedes Anrufs durchführt“, formuliert als „der Prompt, mit dem die KI beurteilt, ob die Bedingung erfüllt ist“. Beim Simulationstest übernimmt eine KI die Rolle des Anrufers, und „jeder Durchlauf wird mit einer schriftlichen Begründung als bestanden oder nicht bestanden bewertet“.
Benchmarks liefern dieselbe Art von Urteil in großem Maßstab. Der Retell vCX Benchmark veröffentlicht jeden Suite-Score als Erfolgsquote, also „den Prozentsatz der getesteten Szenarien, die korrekt bewältigt wurden“ – in den Bereichen Befolgen von Anweisungen, Quellentreue, Tool-Aufrufe und Umgangssprache (Stand: 13. November 2026).
Wie Sie Urteile in ein wöchentliches Review überführen, zeigt die QA-Scorecard für Sprachagenten.
Welche bekannten Fehlerquellen hat ein LLM-Richter?
Ein LLM-Richter versagt auf vier dokumentierte Arten. Für jede gibt es eine bewährte Gegenmaßnahme.
- Positions-Bias. In Large Language Models are not Fair Evaluators genügte es, die Reihenfolge zweier Antworten zu vertauschen, damit ein Modell „bei 66 von 80 getesteten Anfragen“ gewann. Führen Sie jeden Vergleich in beiden Reihenfolgen durch.
- Selbstbevorzugung. Eine Studie aus dem Jahr 2024 stellte fest, dass ein Bewerter „seine eigenen Ausgaben höher bewertet als die anderer, obwohl menschliche Annotatoren sie als gleichwertig einstufen“. Verwenden Sie einen Richter aus einer anderen Modellfamilie oder ein Gremium.
- Geringe Übereinstimmung mit Menschen. Judging the Judges testete dreizehn Richtermodelle und kam zu dem Ergebnis, dass „nur die besten (und größten) Modelle eine angemessene Übereinstimmung mit Menschen erreichen“, mit „einer Tendenz zur Nachsicht“. Bewerten Sie eine Stichprobe von Hand und vergleichen Sie.
- Drift. Das Modell hinter einer API kann sich ändern: Eine Studie maß, dass die Genauigkeit von GPT-4 bei derselben Aufgabe innerhalb von drei Monaten von 84 % auf 51 % fiel. Auch Kriterien verschieben sich. Who Validates the Validators? nennt dies Kriterien-Drift: „Nutzer brauchen Kriterien, um Ausgaben zu bewerten, aber das Bewerten von Ausgaben hilft Nutzern erst, Kriterien zu definieren.“ Legen Sie die Version des Richters fest und führen Sie nach jeder Änderung einen festen, von Hand gelabelten Datensatz erneut aus.
Richter sind zudem nicht deterministisch. Die Simulationsdokumentation von Retell rät: „Beurteilen Sie ein Szenario anhand seiner Erfolgsquote über mehrere Durchläufe, nicht anhand eines einzelnen Durchlaufs.“
Wann sind Code-Prüfungen einem LLM-Richter überlegen?
Code-Prüfungen sind einem LLM-Richter immer dann überlegen, wenn sich die Antwort verifizieren lässt, statt gelesen werden zu müssen. Der Leitfaden von Anthropic zu Agent-Evals empfiehlt, „wo möglich deterministische Bewerter und wo nötig LLM-Bewerter zu wählen“. Codebasierte Bewerter beschreibt er als schnell, günstig, objektiv und reproduzierbar, modellbasierte Bewerter als nicht deterministisch.
Bei einem Anruf kann Code prüfen, ob das vom Agenten aufgerufene Tool existiert, ob seine Argumente gültig sind und ob die Antwortzeit unter einem Schwellenwert blieb. tau-bench bewertet ganze Gespräche auf diese Weise und vergleicht „den Datenbankzustand am Ende eines Gesprächs mit dem annotierten Zielzustand“.
AI QA von Retell trennt beides: Leistungsmetriken sind quantitative Schwellenwerte, KI-bewertete Bedingungen übernehmen die qualitativen Prüfungen. Änderungen an Sprachagenten testen und veröffentlichen erklärt, wo welche Prüfung läuft.
Wie werden Richtergremien beim Training eines Sprachmodells eingesetzt?
Tell-1, das eigene LLM von Retell, nutzte laut dem technischen Beitrag zum Retell LLM in zwei seiner drei Trainingsphasen LLM-Richter. Die Phase des Preference-Tunings lernte aus „Präferenzpaaren, die von einem Gremium aus LLM-Richtern gerankt wurden“.
In der Phase des Reinforcement Learning, so der Beitrag, „schreibt das Modell acht Antworten, und jede einzelne wird bewertet“. Zuerst läuft Code: Aufrufe von Tools außerhalb der Toolbox des Agenten, fehlerhaft formatierte Ausgaben und andere kritische Fehler „werden im Code abgefangen, bevor ein Richter sie zu sehen bekommt“. Für die Korrektheit gilt: „Mehrere Richtermodelle bewerten die Korrektheit der Tool-Aufrufe, Halluzinationen und das Befolgen von Anweisungen, und ihre Urteile werden zu einem einzigen Reward-Signal zusammengeführt.“ Für die Natürlichkeit rankt ein einzelner Richter alle acht Antworten nebeneinander anhand einer Rubrik, denn „Natürlichkeit lässt sich leichter vergleichen als bewerten“.
Genau dieses Muster beschreibt diese Seite: Code-Prüfungen für das, was sich verifizieren lässt, ein Richtergremium für die Korrektheit und ein Ranking für den Tonfall.
Häufig gestellte Fragen zu LLM als Richter
Was macht ein LLM-Richter?
Er liest eine Ausgabe, etwa ein Anruftranskript, zusammen mit Bewertungsanweisungen und gibt ein Urteil zurück: bestanden oder nicht bestanden, einen Score oder eine Präferenz zwischen zwei Optionen.
Wie zuverlässig ist LLM als Richter?
Das hängt vom Richtermodell und von der Aufgabe ab. Eine Studie ergab eine Übereinstimmung von über 80 % mit menschlichen Präferenzen; eine andere stellte fest, dass nur die größten Richter angemessen mit Menschen übereinstimmten. Prüfen Sie einen Richter zuerst anhand von Hand bewerteter Anrufe.
Was ist ein Richtergremium?
Bei einem Richtergremium bewerten mehrere Richtermodelle dieselbe Ausgabe, und ihre Urteile werden zusammengeführt. Das verringert den Einfluss des Bias eines einzelnen Modells.
Was ist der Unterschied zwischen Rubrik-Bewertung und paarweisem Ranking?
Bei der Rubrik-Bewertung wird eine Ausgabe anhand schriftlicher Kriterien bewertet. Beim paarweisen Ranking werden dem Richter zwei Ausgaben gezeigt, und er wird gefragt, welche besser ist.
Kann ein LLM-Richter einen Sprachanruf bewerten?
Ja, anhand des Transkripts und der Tool-Aufrufe. Für Eigenschaften, die sich im Audio zeigen, wird zusätzlich das Audio benötigt: Laut der Dokumentation von Retell wird Agent Naturalness „sowohl anhand des Audios als auch des Transkripts bewertet“.
Bewerten Sie Ihre eigenen Anrufe, bevor Sie skalieren
Die Retell AI ist eine Plattform für KI-Sprachagenten für Contact Center. AI QA bewertet eine Stichprobe Ihrer Anrufe anhand der von Ihnen festgelegten Bedingungen und Schwellenwerte – mit Belegen aus dem Transkript für jedes Ergebnis.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


