Session Affinity, auch Sticky Sessions oder Session Persistence genannt, ist ein Load-Balancing-Verfahren, das jede Anfrage desselben Clients bzw. derselben Sitzung an denselben Backend-Server sendet, sodass der im Arbeitsspeicher dieses Servers gehaltene Zustand erreichbar bleibt.
Ohne sie wird jede Anfrage für sich verteilt. AWS schreibt, dass ein Application Load Balancer standardmäßig „jede Anfrage unabhängig an ein registriertes Ziel weiterleitet“ und dass die Sticky-Session-Funktion es ermöglicht, „die Sitzung eines Nutzers an ein bestimmtes Ziel zu binden“. Das ist wichtig, wenn ein Server lokal etwas vorhält, das die nächste Anfrage benötigt: eine Login-Sitzung, einen Warenkorb oder einen Cache.
Wie setzen Load Balancer Session Affinity um?
Ein Load Balancer braucht eine Möglichkeit, die Sitzung zu erkennen, und eine Regel, die sie einem Server zuordnet. Drei Methoden decken die meisten Produkte ab.
Cookie. Der Load Balancer setzt bei der ersten Antwort ein Cookie und liest es bei späteren Anfragen aus. Die dauerbasierte Stickiness von AWS verwendet ein Cookie namens AWSALB mit einer Lebensdauer, die Sie zwischen 1 Sekunde und 7 Tagen festlegen. HAProxy nutzt ein Cookie, um sich zu „merken, an welchen Server der Client zuvor geleitet wurde“. Der Client muss Cookies unterstützen.
IP-Hash. Die IP-Adresse des Clients bestimmt den Server. ip_hash von NGINX verwendet „die ersten drei Oktette der IPv4-Adresse des Clients oder die gesamte IPv6-Adresse“ als Hash-Schlüssel. Ein Kubernetes Service bietet dasselbe Prinzip als sessionAffinity: ClientIP mit einem Standard-Timeout von 3 Stunden. Keines von beiden benötigt ein Cookie, doch Clients hinter einer gemeinsamen Adresse landen auf demselben Server – und bei NGINX auch alle, die sich diese drei Oktette teilen.
Consistent Hashing. Der Load Balancer bildet eine Eigenschaft der Anfrage, etwa einen Header oder eine Session-ID, per Hash auf einen Ring von Servern ab. Envoy schreibt, dass bei einem gut partitionierten Ring das Hinzufügen oder Entfernen eines Hosts aus einer Menge von N „nur 1/N der Anfragen betrifft“. Die hash-Direktive von NGINX hat eine Option consistent, die laut Dokumentation „hilft, eine höhere Cache-Trefferquote bei Caching-Servern zu erzielen“.
| Methode | Woran die Sitzung erkannt wird | Dokumentiertes Beispiel | Haupteinschränkung |
|---|---|---|---|
| Cookie | Ein vom Load Balancer oder der Anwendung gesetztes Cookie | AWS Application Load Balancer, HAProxy | Der Client muss Cookies unterstützen |
| IP-Hash | Die IP-Adresse des Clients | NGINX ip_hash, Kubernetes ClientIP | Clients hinter einer gemeinsamen Adresse landen gebündelt auf einem Server |
| Consistent Hashing | Eine beliebige Eigenschaft der Anfrage | Envoy Ring Hash und Maglev, NGINX hash ... consistent | Jede Anfrage muss einen stabilen Schlüssel enthalten |
| Präfixbasiertes Routing | Die ersten Tokens eines LLM-Prompts | OpenAI Prompt Caching, Ray Serve | Die Auslastung zählt weiterhin, daher kann ein ausgelasteter Server die Anfrage verlieren |
Welche Kompromisse bringen Sticky Sessions mit sich?
Session Affinity opfert etwas Lastverteilung und Ausfallsicherheit, um den Zustand nah zu halten.
- Die Last kann ungleich verteilt sein. Google Cloud schreibt, dass Affinity „gut funktioniert, wenn es eine ausreichend große Verteilung eindeutiger Verbindungen gibt“. Bei wenigen oder ungleichmäßigen Sitzungen tragen manche Server mehr Last, was der Skalierbarkeit entgegenwirkt.
- Ein ausgefallener Server beendet die Affinity. Fällt bei AWS ein Ziel aus, „wählt der Load Balancer ein neues fehlerfreies Ziel“ und hält die Sitzung dort, „selbst wenn das ausgefallene Ziel wieder verfügbar ist“. Alles, was nur im Arbeitsspeicher des alten Servers lag, muss neu aufgebaut werden.
- Sie funktioniert nach dem Best-Effort-Prinzip. Google Cloud stellt Session Affinity „auf Best-Effort-Basis“ bereit und nennt Änderungen bei Health Checks, hinzugefügte oder entfernte Backends sowie ausgelastete Backends als Ereignisse, die sie unterbrechen können.
Die Dokumentation von HAProxy gibt den üblichen Rat: „Oft ist es optimal, ganz auf Session Persistence zu verzichten, indem Sie Ihre Dienste zustandslos gestalten“, etwa indem Sie den Zustand in einer gemeinsamen Datenbank speichern. Affinity ist für Zustand gedacht, den Sie nicht kostengünstig verlagern können. Ein Cache ist der typische Fall.
Warum ist Session Affinity für das LLM-Serving wichtig?
Weil der Cache, der einen wiederholten Prompt günstig macht, auf einer einzelnen Maschine liegt. Ein Modellserver hält den berechneten Zustand eines Prompts, den KV-Cache, im Arbeitsspeicher. vLLM verwendet ihn wieder, wenn eine neue Anfrage „dasselbe Präfix wie eine der bestehenden Anfragen hat, sodass die neue Anfrage die Berechnung des gemeinsamen Teils überspringen kann“.
Das funktioniert nur, wenn die nächste Anfrage dieselbe Maschine erreicht. Der Leitfaden zum Prompt Caching von OpenAI sagt es direkt: „Gecachte Zustände liegen auf einzelnen Maschinen“, und „eine Anfrage kann ein gecachtes Präfix nur wiederverwenden, wenn sie eine Maschine erreicht, die einen passenden, nicht abgelaufenen Eintrag hält“. OpenAI routet anhand der Maschinenauslastung, eines Hashs der ersten Tokens des Prompts und – bei älteren Modellen – eines von Ihnen angegebenen Cache-Schlüssels. Für selbst gehostete Modelle liefert Ray Serve einen Router, der „Anfragen mit ähnlichen Präfixen an dieselben Replikas leitet und so die KV-Cache-Trefferquote maximiert“, und bei ungleichmäßigen Warteschlangen auf einfaches Load Balancing zurückfällt.
Telefonanrufe passen genau in dieses Muster. Bei jedem Turn einer mehrstufigen Konversation sendet ein Sprachagent dem großen Sprachmodell seine Anweisungen plus das bisherige Transkript, denn das Modell behält den Anruf zwischen den Anfragen nicht. Jede Anfrage wiederholt den Großteil der vorherigen. Der Anruf ist also die Sitzung, und die Call-ID ist ein naheliegender Schlüssel. Ein Turn, der auf einem anderen Server landet, verarbeitet den gesamten Prompt erneut, was die Latenz erhöht.
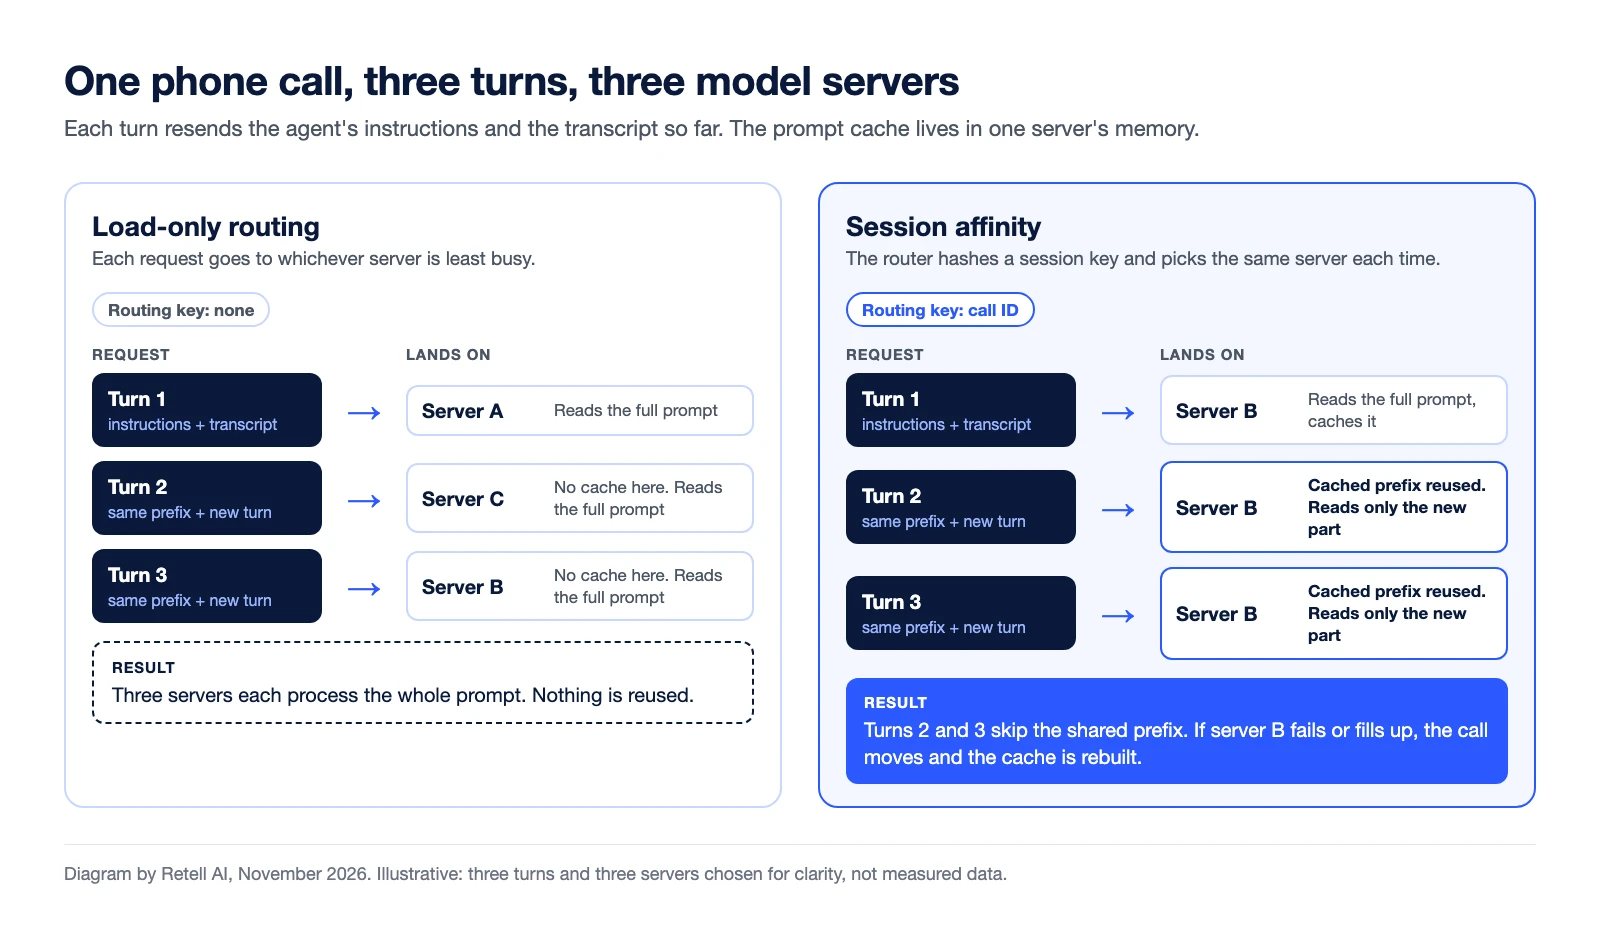
Tell-1, das eigene LLM von Retell, wird auf diese Weise bereitgestellt. Der technische Beitrag zum Retell LLM nennt das anrufbewusstes Routing: Jeder Turn sendet die gesamte Konversation erneut, daher wird jeder Anruf auf den GPUs gehalten, die ihn bereits im Cache haben. Laut dem Beitrag stieg dadurch der Anteil der aus dem Cache bedienten Prompt-Tokens von 36 % auf 69 %.
Wo Session Affinity bei Retell eine Rolle spielt
Sie spielt eine Rolle, wenn Sie Ihren eigenen Modellserver betreiben. Mit einem benutzerdefinierten LLM „öffnet Retell für jeden Anruf einen WebSocket zu Ihrem Server“, wobei die Call-ID das letzte Pfadsegment der URL ist. AWS weist darauf hin, dass „WebSocket-Verbindungen von Natur aus sticky sind“, sodass ein Anruf auf einem Ihrer Server bleibt, solange sein Socket offen ist.
Die Best Practices von Retell empfehlen, „expliziten Zustand pro Anruf auf Ihrem Server zu halten, verknüpft mit der Call-ID aus der WebSocket-URL“. Retell baut außerdem eine Verbindung neu auf, die während eines Anrufs abbricht – und wenn Sie mehrere Server hinter einem Load Balancer betreiben, kann der neue Socket einen anderen Server erreichen. Damit der Zustand erreichbar bleibt, routen Sie anhand der Call-ID im Pfad oder halten Sie diesen Zustand in einem gemeinsamen Speicher. IP-Hash verteilt die Last hier nicht: Die Einrichtungsanleitung nennt eine einzige ausgehende IP-Adresse für diese Verbindung, sodass jeder Anruf auf denselben Server gehasht wird.
Häufig gestellte Fragen zu Session Affinity
Ist Session Affinity dasselbe wie Sticky Sessions?
Ja. AWS beschreibt seine Sticky-Session-Funktion als „auch bekannt als Session Affinity“. Session Persistence ist ein dritter Name für dasselbe.
Was passiert mit einer Sticky Session, wenn der Server ausfällt?
Der Load Balancer wählt einen anderen fehlerfreien Server, und die Sitzung bleibt dort. Zustand, der nur im Arbeitsspeicher des ausgefallenen Servers lag, geht verloren, sofern er nicht zusätzlich an einem gemeinsamen Ort gespeichert wurde.
Benötigen WebSocket-Verbindungen Sticky Sessions?
Nicht, solange die Verbindung offen ist, denn jede Nachricht läuft über dieselbe Verbindung zum selben Server. Wichtig wird Affinity wieder, wenn sich der Client neu verbindet.
Warum ist Session Affinity für das Prompt Caching wichtig?
Ein Prompt-Cache liegt im Arbeitsspeicher der Maschine, die ihn erstellt hat. Eine Folgeanfrage erhält das gecachte Präfix nur, wenn sie an diese Maschine geleitet wird.
Bringen Sie Ihr eigenes Modell in Live-Anrufe
Die Retell AI ist eine Plattform für KI-Sprachagenten für Contact Center. Retell übernimmt Telefonie, Transkription, Turn-Taking und Sprachausgabe, und die Integration für benutzerdefinierte LLMs verbindet Ihren Modellserver über einen WebSocket pro Anruf.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


