Time to First Token (TTFT) ist die Zeit zwischen dem Senden einer Anfrage an ein Large Language Model (LLM) und dem Empfang des ersten Tokens seiner Antwort. Sie misst, wie schnell ein Modell zu antworten beginnt, nicht wie lange die Antwort dauert.
Der Benchmarking-Leitfaden von NVIDIA definiert sie als „die Zeit von der Übermittlung der Anfrage bis zum ersten empfangenen Token“. Bei einem Telefonanruf ist die TTFT ein Teil der Latenz, die ein Anrufer wahrnimmt. Zwei weitere Messgrößen bauen darauf auf: die Zeit bis zum ersten Satz (Time to First Sentence) und die End-to-End-Sprachlatenz.
Was umfasst die TTFT?
Die TTFT umfasst alles, was geschieht, bevor das Modell sein erstes Token streamt. IBM nennt vier Bestandteile: Wartezeit in der Warteschlange, Prefill-Zeit (Verarbeitung des Prompts), Generierung des ersten Tokens sowie Netzwerk- und API-Overhead.
IBM bezeichnet den Prefill als „oft den größten Faktor der TTFT, besonders bei längeren Prompts“. Das Modell liest den gesamten Prompt, bevor es etwas schreibt – ein längerer Prompt bedeutet also längeres Warten. Auch die Last spielt eine Rolle. Die Dokumentation von Anyscale weist darauf hin, dass ein stark ausgelasteter Server eingehende Anfragen in eine Warteschlange stellen kann, und diese Wartezeit erhöht die TTFT.
Wie misst man die TTFT?
- TTFT = Zeitpunkt des Empfangs des ersten Tokens minus Zeitpunkt des Sendens der Anfrage
Drei Entscheidungen verändern das Ergebnis. Geben Sie sie bei jedem TTFT-Wert mit an:
- Wo die Uhr läuft. Am Client gemessen, enthält die TTFT die Netzwerkzeit. Innerhalb des Modellservers gemessen, enthält sie diese nicht.
- Welches Perzentil. Der Median (P50) zeigt die typische Anfrage. P90 und P99 zeigen die langsamen.
- Wie viel Last. Eine einzelne Anfrage auf einem unbelasteten Server ist der Bestfall. Im Produktivbetrieb, so NVIDIA, kann sich der Prefill einer Anfrage mit der Generierung einer anderen überschneiden.
Wie unterscheiden sich TTFT, Zeit bis zum ersten Satz und End-to-End-Latenz bei einem Telefonanruf?
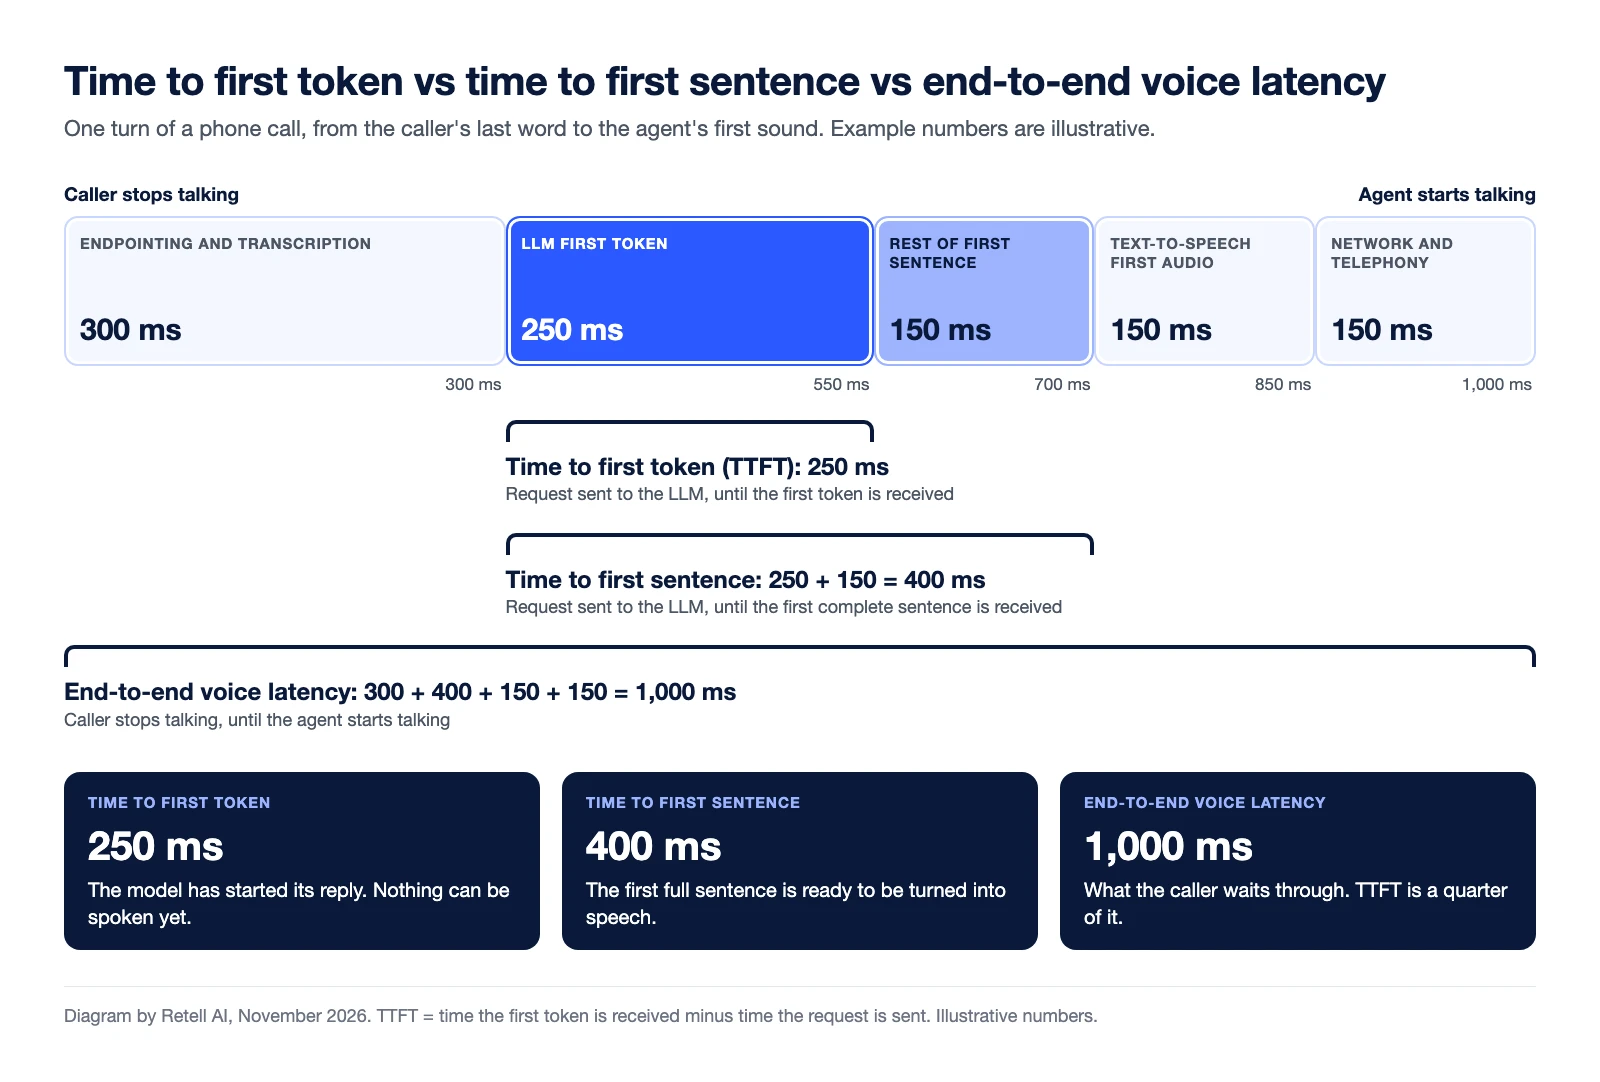
Die TTFT endet beim ersten Token. Die Zeit bis zum ersten Satz endet, wenn ein vollständiger Satz eingetroffen ist. Die End-to-End-Sprachlatenz umfasst die gesamte Pause, die der Anrufer hört.
Ein Anrufer hört nie ein Token. Die Best Practices für benutzerdefinierte LLMs von Retell besagen: „Retell beginnt zu sprechen, sobald Ihr erster vollständiger Satz vorliegt.“ Entscheidend ist dort die „Time to First Token plus die Zeit bis zum Abschluss dieses ersten Satzes“.
Die Latenz-Dokumentation von Retell misst die End-to-End-Latenz „ab dem Moment, in dem der Nutzer aufhört zu sprechen, bis zu dem Moment, in dem der Agent zu sprechen beginnt“.
| Messgröße | Uhr startet | Uhr stoppt | Nicht enthalten |
|---|---|---|---|
| Time to First Token (TTFT) | Anfrage an das LLM gesendet | Erstes Token empfangen | Der Rest des ersten Satzes, Spracherkennung, Sprachsynthese |
| Zeit bis zum ersten Satz | Anfrage an das LLM gesendet | Erster vollständiger Satz empfangen | Spracherkennung, Sprachsynthese, Telefonie |
| End-to-End-Sprachlatenz | Anrufer hört auf zu sprechen | Agent beginnt zu sprechen | Nichts in der Pipeline. Prüfen Sie, ob der Wert die Netzwerkstrecke zum Anrufer einschließt |
Eine Begriffsfalle: Im LLM-Benchmarking reicht die End-to-End-Latenz bis zum letzten Token. NVIDIA definiert sie als „die Zeit von der Übermittlung einer Anfrage bis zum Empfang der vollständigen Antwort“.
Rechenbeispiel (illustrative Zahlen). Ein Gesprächswechsel in einem Anruf:
- Endpointing und Transkription: 300 ms
- Erstes Token des LLM: 250 ms
- Rest des ersten Satzes: 150 ms (15 weitere Tokens à 10 ms)
- Erstes Audio der Sprachsynthese (Text-to-Speech): 150 ms
- Netzwerk und Telefonie: 150 ms
Die TTFT beträgt 250 ms. Die Zeit bis zum ersten Satz beträgt 250 + 150 = 400 ms. Die End-to-End-Sprachlatenz beträgt 300 + 400 + 150 + 150 = 1.000 ms – die TTFT macht also ein Viertel der Wartezeit des Anrufers aus. Unser Leitfaden zu Latenz-Benchmarks für Sprach-KI verwendet dasselbe Budget.
Warum kann die TTFT beim Vergleich von Modellen in die Irre führen?
Ein TTFT-Wert ist nur mit einem anderen TTFT-Wert vergleichbar, der auf dieselbe Weise ermittelt wurde. Stellt man die TTFT eines Modells der Zeit bis zum ersten Satz eines anderen gegenüber, wirkt das erste immer schneller. Dasselbe gilt für reine Modellzeit im Vergleich zu einer in einem Live-Anruf gemessenen Zeit sowie für einen Median im Vergleich zu einem P99.
Ein Modell kann zudem sein erstes Token schnell senden und danach langsam streamen – der Anrufer bleibt dann trotzdem in der Stille.
Wie senken Sie die TTFT bei einem Sprachagenten?
Der Leitfaden zur Latenz-Fehlerbehebung von Retell nennt die Modellwahl und die Prompt-Länge als die zwei häufigsten Ursachen hoher Latenz.
- Wählen Sie ein schnelleres Modell. Tell-1 ist eine für Anrufe entwickelte Option. Laut Leitfaden sind größere, auf Reasoning ausgerichtete Modelle „langsamer bis zum ersten Token“.
- Kürzen Sie den Prompt. „Jedes Token in Ihrem Prompt erhöht die Time to First Token“ – bei jedem Gesprächswechsel. Prompts mit mehr als etwa 8.000 Tokens werden spürbar langsamer.
- Streamen Sie die Antwort. Wird bei einem benutzerdefinierten LLM die vollständige Antwort in einem einzigen Event gesendet, „fällt die gesamte Generierung in die Stille des Anrufers“.
Die Get Call API von Retell liefert für jeden Anruf die End-to-End-, LLM- und Text-to-Speech-Latenz bei P50, P90, P95 und P99. Der LLM-Wert reicht „bis zum ersten empfangenen sprechbaren Chunk“ – er misst also sprechbaren Text, nicht das erste Roh-Token.
Manche Modelle sind gezielt auf diese Messgröße ausgelegt. Tell-1, das eigene LLM von Retell, beginnt seine Antwort und setzt das Reasoning fort, während die erste Phrase abgespielt wird. Es erzielt die niedrigste Medianlatenz im Retell vCX Benchmark mit 76 ms, gemessen als gleitender 24-Stunden-Median der Zeit bis zum ersten Satz (abgerufen am 13. November 2026). Der technische Beitrag zum Retell LLM erklärt die Funktionsweise – und die Modellzeit ist nur ein Teil der End-to-End-Sprachlatenz.
Häufig gestellte Fragen zur Time to First Token
Was ist eine gute Time to First Token?
Es gibt keinen einheitlichen Standard. Sie hängt vom Modell, der Prompt-Länge und der Serverlast ab. Bei einem Sprachagenten sollten Sie sie im Rahmen des End-to-End-Werts beurteilen. Die Dokumentation von Retell empfiehlt, die geschätzte Latenz eines Agenten unter 1,5 Sekunden zu halten.
Ist TTFT dasselbe wie Latenz?
Nein. Die TTFT ist die Verzögerung des LLM bis zu seinem ersten Token. Die Latenz bei einem Anruf ist die gesamte Pause zwischen dem Moment, in dem der Anrufer fertig ist, und dem Moment, in dem der Agent zu sprechen beginnt.
Enthält die TTFT die Netzwerkzeit?
Das hängt davon ab, wo gemessen wird. Laut NVIDIA umfasst die TTFT „in der Regel die Wartezeit der Anfrage in der Warteschlange, die Prefill-Zeit und die Netzwerklatenz“. Ein reiner Modellwert, der innerhalb des Servers ermittelt wird, lässt das Netzwerk außen vor.
Was ist der Unterschied zwischen TTFT und der Zeit bis zum ersten Satz?
Die TTFT endet beim ersten Token. Die Zeit bis zum ersten Satz endet, wenn der erste vollständige Satz eingetroffen ist – also dann, wenn ein Sprachagent zu sprechen beginnen kann.
Messen Sie die Latenz Ihrer eigenen Anrufe
Die Retell AI ist eine Plattform für KI-Sprachagenten für Contact Center. Die Anrufhistorie (Call History) zeigt die Latenz für jeden Anruf, aufgeschlüsselt nach Komponenten in der Get Call API. Sprechen Sie mit dem Retell-Team.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


