Prompt Caching ist eine Technik, mit der ein Large Language Model Arbeit überspringen kann, die es bereits erledigt hat: Beginnt eine neue Anfrage mit denselben Tokens wie eine frühere, nutzt das Modell die gespeicherte Berechnung für diesen gemeinsamen Anfang wieder und verarbeitet nur das Neue. Das Ergebnis ist ein schnelleres erstes Token und bei den meisten APIs ein niedrigerer Preis für die wiederverwendeten Tokens.
Der wiederverwendete Teil heißt Präfix. Der Leitfaden von OpenAI definiert ihn als „die unveränderten Tokens am Anfang eines Prompts“. Dort stehen in der Regel Anweisungen, Tool-Definitionen und frühere Gesprächsrunden.
Wie funktioniert Prompt Caching?
Die Dokumentation von Anthropic beschreibt den Ablauf: Das System prüft, ob ein Prompt-Präfix aus einer kürzlichen Anfrage bereits im Cache liegt, verwendet in diesem Fall die zwischengespeicherte Version und verarbeitet andernfalls den vollständigen Prompt und legt das Präfix im Cache ab.
Aus diesem Design ergeben sich drei Regeln:
- Die Übereinstimmung muss exakt sein. Laut Anthropic erfordern Cache-Treffer „zu 100 Prozent identische Prompt-Segmente“. Ein einziges geändertes Zeichen früh im Prompt bedeutet, dass alles danach erneut verarbeitet wird.
- Die Reihenfolge zählt. Stabile Inhalte kommen zuerst, veränderliche Inhalte zuletzt.
- Einträge laufen ab. Die Standard-Lebensdauer des Caches beträgt bei Anthropic 5 Minuten und wird bei jeder Nutzung des zwischengespeicherten Inhalts erneuert. Bei OpenAI hängt die Lebensdauer vom Modell ab.
Wie hängen Prompt Caching, Prefix Caching und der KV-Cache zusammen?
Es sind drei Ebenen derselben Idee. Der KV-Cache sind die Daten, Prefix Caching ist die Wiederverwendung dieser Daten über Anfragen hinweg, und Prompt Caching ist der Name, den API-Anbieter dieser Funktion geben.
| Begriff | Was es ist | Geltungsbereich | Wo der Begriff vorkommt |
|---|---|---|---|
| KV-Cache | Die Key- und Value-Zustände, die ein Modell für jedes gelesene Token berechnet und speichert, damit sie nicht für jedes neue Token neu berechnet werden | Innerhalb einer Anfrage | Modellinterna, Inferenz-Engines |
| Prefix Caching | Den KV-Cache nach dem Ende einer Anfrage behalten und für eine spätere Anfrage wiederverwenden, die mit denselben Tokens beginnt | Über Anfragen auf demselben Server hinweg | Inferenz-Engines wie vLLM |
| Prompt Caching | Prefix Caching als API-Funktion, mit Regeln für Lebensdauer, Mindestlänge und Preis | Über API-Aufrufe hinweg | Dokumentation und Preisseiten von Modellanbietern |
Ein Erklärartikel auf Hugging Face beschreibt den KV-Cache ganz einfach: „Anstatt alles von Grund auf neu zu berechnen, nutzt das Modell wieder, was es bereits berechnet hat“. Laut der vLLM-Dokumentation „speichert“ das automatische Prefix Caching „den KV-Cache bestehender Anfragen, sodass eine neue Anfrage den KV-Cache direkt wiederverwenden kann, wenn sie dasselbe Präfix hat“. OpenAI bestätigt den Zusammenhang von API-Seite: „Der Prompt-Cache speichert Key-Value-(KV-)Tensoren, nicht die Tokens selbst.“
Warum ist Prompt Caching bei einem Telefonanruf mit mehreren Gesprächsrunden wichtig?
Ein Sprachagent ruft das Modell einmal pro Gesprächsrunde auf, und jede Anfrage enthält die Anweisungen, die Tool-Definitionen und das bisherige Gespräch. In einem Multi-Turn-Gespräch ist fast alles davon identisch mit der Anfrage der vorherigen Runde. Nur der letzte Austausch ist neu. Ohne Caching liest das Modell in jeder Runde dieselben Anweisungen erneut.
Rechenbeispiel (illustrative Zahlen). Ein Agent hat 2.500 Tokens an Anweisungen und Tools, jede Runde fügt 100 Tokens Gespräch hinzu, und jede Runde nach der ersten findet ihr Präfix im Cache:
| Runde | Prompt-Tokens | Aus dem Cache wiederverwendet | Neu zu lesende Tokens |
|---|---|---|---|
| 1 | 2.600 | 0 | 2.600 |
| 2 | 2.700 | 2.600 | 100 |
| 5 | 3.000 | 2.900 | 100 |
| 10 | 3.500 | 3.400 | 100 |
| Alle 10 Runden | 30.500 | 27.000 | 3.500 |
Über den gesamten Anruf stammen 27.000 von 30.500 Prompt-Tokens (etwa 89 %) aus dem Cache. Ab der zweiten Runde liest das Modell 100 neue Tokens statt mehr als 2.600.
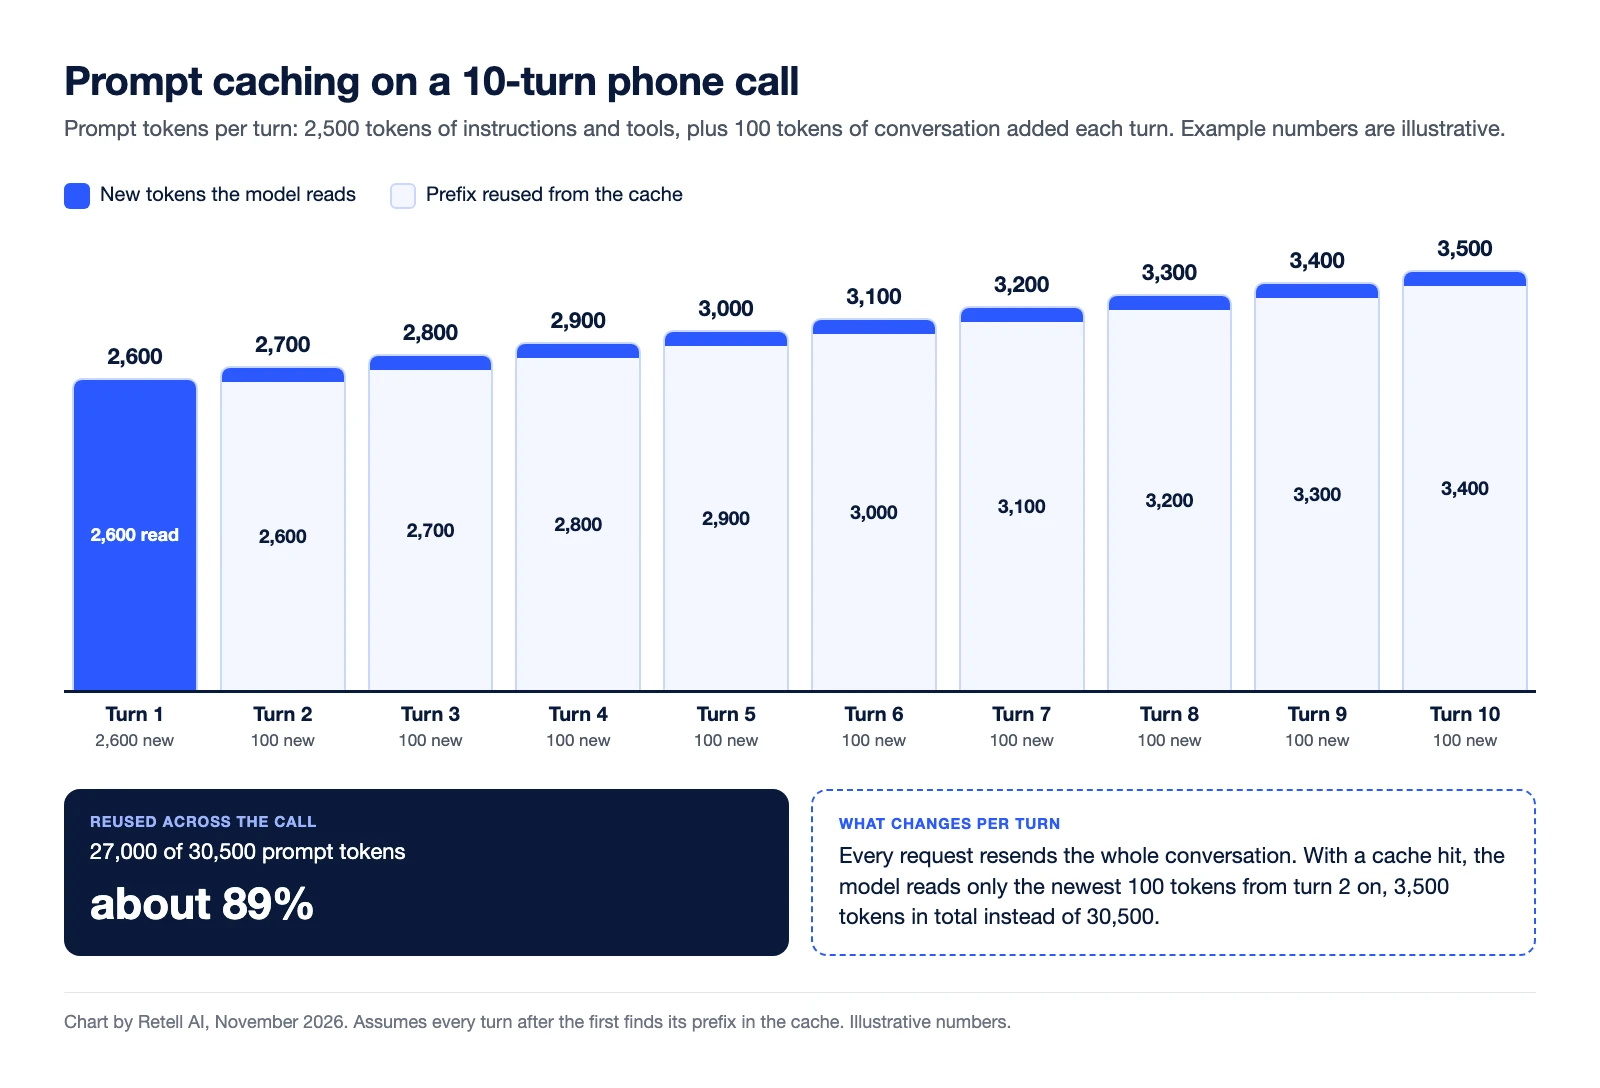
Das ist aus zwei Gründen wichtig. Die Time to First Token ist Teil der Latenz, die ein Anrufer als Stille wahrnimmt, und das Lesen eines langen Prompts kostet Zeit. Der zweite Grund sind die Kosten: Anthropic berechnet für Cache-Lesevorgänge das 0,1-Fache des Basispreises für Input-Tokens, für Cache-Schreibvorgänge mit 5 Minuten Lebensdauer das 1,25-Fache.
Was verhindert einen Cache-Treffer?
- Ein geändertes Präfix. Ein Zeitstempel, der Name eines Anrufers oder eine umsortierte Tool-Liste weit oben im Prompt verändert jedes nachfolgende Token.
- Eine Pause, die länger ist als die Lebensdauer des Caches.
- Die Anfrage landet auf einer anderen Maschine. Laut dem Leitfaden von OpenAI „liegen zwischengespeicherte Zustände auf einzelnen Maschinen“, und eine Anfrage kann ein Präfix „nur dann wiederverwenden, wenn sie eine Maschine erreicht, die einen passenden, noch nicht abgelaufenen Eintrag hält“.
Routing kann diese letzte Lücke schließen. Tell-1, das eigene LLM von Retell, hält jeden Anruf mithilfe von Session Affinity auf den GPUs, die ihn bereits im Cache haben. Laut dem technischen Beitrag zum Retell LLM verdoppelt das nahezu den Anteil der aus dem Cache bedienten Prompt-Tokens, von 36 % auf 69 %, sodass in jeder Runde weniger einzulesen ist und Antworten früher beginnen.
Caching ändert die Antwort nicht. Laut den Designnotizen von vLLM „ändert“ Prefix Caching „die Modellausgaben nicht“.
Die Rolle von KI-Sprachagenten
Der Leitfaden zur Fehlerbehebung bei Latenz von Retell benennt die Kosten der Prompt-Länge direkt: „Jedes Token in Ihrem Prompt erhöht die Time to First Token, und diese Kosten fallen in jeder Runde des Gesprächs an.“
Wenn Sie Ihr eigenes Modell über den LLM WebSocket von Retell anbinden, kommt jede Antwortanfrage mit dem „vollständigen Live-Transkript, das bisher im Anruf erfasst wurde“ an. Ihr Server baut den Prompt auf, daher hängt das Cache-Verhalten davon ab, wie Sie ihn aufbauen, und von Ihrem Modellanbieter: Stellen Sie Anweisungen und Tools unverändert an den Anfang und hängen Sie das Transkript danach an. Den vollständigen Weg einer Gesprächsrunde finden Sie unter So funktioniert Sprach-KI in Echtzeit.
Häufige Fragen zu Prompt Caching
Was ist der Unterschied zwischen Prompt Caching und dem KV-Cache?
Der KV-Cache ist der gespeicherte Attention-Zustand, den ein Modell beim Lesen von Tokens aufbaut. Prompt Caching bewahrt diesen Zustand nach dem Ende einer Anfrage auf, sodass eine spätere Anfrage mit denselben Anfangstokens ihn wiederverwenden kann.
Ist Prefix Caching dasselbe wie Prompt Caching?
Es handelt sich um denselben Mechanismus. Prefix Caching ist der Begriff, den Inferenz-Engines verwenden. Prompt Caching ist der Produktname, den Modellanbieter in ihren APIs dafür nutzen.
Verändert Prompt Caching die Antwort des Modells?
Nein. Es überspringt nur die erneute Berechnung des gemeinsamen Präfixes.
Wie lange hält ein Prompt-Cache?
Das hängt vom Anbieter ab. Bei Anthropic beträgt der Standard 5 Minuten, erneuert bei jeder Nutzung, mit einer Option für 1 Stunde zu einem höheren Schreibpreis. Bei OpenAI hängt die Lebensdauer vom Modell ab.
Warum ist Prompt Caching für Sprachagenten wichtig?
In jeder Runde eines Anrufs werden die Anweisungen und das bisherige Gespräch erneut gesendet. Bei einem Cache-Treffer liest das Modell nur den neuesten Austausch.
Hören Sie den Unterschied bei Ihren eigenen Anrufen
Die Retell AI ist eine Plattform für KI-Sprachagenten für Contact Center. Tell-1 ist ihr eigenes LLM, entwickelt für Telefonanrufe. Die Dokumentation zeigt, wie Sie die Latenz jedes Anrufs nach Komponenten prüfen, damit Sie sehen, wie viel der Wartezeit auf das Modell entfällt. Sprechen Sie mit dem Retell-Team.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


