プロダクトチームが音声AIプラットフォームに求めるもの




音声AIプラットフォームとは、プロダクトチームが電話やWeb通話で動作するAI音声エージェントを構築、接続、テスト、運用するためのソフトウェアです。プロダクトやエンジニアリングのリーダーが、デモだけでプラットフォームを選ぶことはほとんどありません。候補に残ったプラットフォームそれぞれで同じエージェントを構築し、次の4点を自らの手で確認します。最初に動作するエージェントがどれだけ早く完成するか、APIとワークフローツールでどこまでできるか、通話相手が応答をどれだけ待つか、そしてパイロットが本番トラフィックに移行したときに何が変わるか、です。
本ガイドは、その実機比較のための計画書です。本ガイドはRetell AIが公開しており、Retell AIはプロダクトチームがVapi、ElevenLabs、Blandと並べて比較するプラットフォームの1つです。他の3社に関する記述は、2026年11月10日に参照した各ベンダーの公式ドキュメントに基づいており、リンクを掲載しています。本ガイドのためにテスト通話は行っていないため、スコアやランキングはありません。Retellに関する記述は、Retellの公開ドキュメント(そこに記載された制限事項を含む)に基づいています。
デモでは見えない、プロダクトチームが確認すべきこととは?
デモが見せるのは、うまくいった1回の通話です。実機比較では、自社のエンジニアが何を構築、接続、測定できるかがわかります。1人のエンジニアに、すべてのプラットフォームで同じ通話タイプ(たとえば自社のスケジューリングAPIに対して予約を取るといった実際のもの)を担当させ、それぞれで同じ4つの結果を記録します。
| 確認項目 | チームが行うこと | 記録する内容 |
|---|---|---|
| 構築のしやすさ | 空のアカウントから最初の通話まで、ベンダーの支援なしでエージェントを構築する | 最初に動作する通話までにかかった時間と、行き詰まったすべてのポイント |
| APIとワークフローの深さ | 通話中に自社のAPIを呼び出す、通話イベントを受信する、コードからエージェントを作成する | 回避策が必要だったステップ |
| 応答レイテンシ | 少なくとも20件の通話を行い、各ターンのタイミングを取得する | 中央値と95パーセンタイル、およびベンダーが用いる定義 |
| パイロットから大規模運用へ | 必要になる前に、制限、障害時の挙動、リリース管理を確認する | デフォルトの制限、上限に達したときの挙動、コストを左右する要素 |
最初に動作するエージェントを、チームはどれだけ早く構築できるか?
空のアカウントから、エンジニアが同僚に見せられる通話ができるまでの時間を測り、ベンダーに支援を求める必要があったポイントをすべて記録します。ドキュメントで解決できた場合はセルフサービスとみなします。
多くのプラットフォームでは、この時間を2つの要素が左右します。1つ目は、エージェントが話せるようになる前にどれだけの構造を設計する必要があるかです。Retellのドキュメントでは、シングルプロンプトエージェントから始めることを推奨しており、シングルプロンプトでは要件を満たせなくなった場合にのみ、タスクを独自の指示を持つノードに分割するカンバセーションフローへ移行するよう勧めています。同じページでは、トレードオフについても「カンバセーションフローが自動的に信頼性が高くなるわけではありません」と率直に述べています。
2つ目は、どれだけ早くエージェントの声を聞き、ミスを発見できるかです。Retellのテストの概要では4つの方法が挙げられています。LLM Playgroundでのテキストチャット、保存したシミュレーションテストケース、「電話番号なし」のブラウザ通話、そして実際の電話です。テスト通話の予算も確保しておきましょう。Retellでは、テストは本番と同じ料金で課金されます。最初の構築の詳しい手順については、AI音声エージェントの構築方法をご覧ください。
構築のしやすさは、プラットフォームが何を代わりに運用してくれるかにも左右されます。Retellのドキュメントによると、Retellは「テレフォニー、音声、言語モデルの各レイヤーを運用するため、プロバイダーを接続する代わりにエージェントを設定するだけで済みます」。チームはその下のインフラを保守することなく、エージェントの挙動を管理できます。このトレードオフが自社に合うかどうかは別の判断であり、AI音声エージェントは自社構築か購入かで解説しています。
APIとワークフローツールはどこまで深いか?
十分な深さとは、2つのことを意味します。エンジニアがダッシュボードで行ったことをコードからも実行できること、そしてエージェントがミドルウェアの開発なしに通話中に自社システムにアクセスできることです。すべてのプラットフォームで次の5つの領域を確認しましょう。
- SDKとAPIのカバー範囲。ダッシュボードのすべての操作にendpointがあるかを確認します。RetellはNode.jsとPython向けの公式SDKを公開しており、音声とチャットのendpointを完全にカバーする型付きクライアントと説明されています。
- 通話中に自社のAPIを呼び出す。Retellのカスタム関数は、自社のendpointにGET、POST、PUT、PATCH、DELETEのいずれかのリクエストを送信し、レスポンスを待ちます。タイムアウトは1〜600秒で、デフォルトは120秒です。リトライ回数を設定しない限り、リクエストは再試行されません。遅いリクエストの処理中に通話相手に何が聞こえるかを、各ベンダーに確認しましょう。
- 通話イベント。Retellのwebhookは、call_started、call_ended、call_analyzedの各イベントを自社サーバーに送信します。それぞれのタイムアウトは10秒で、最大3回まで再試行されます。署名ヘッダーにより送信元を検証できます。
- 双方向のMCP。Retellのエージェントは、ライブ通話中にリモートMCPサーバーのツールを呼び出すことができます。Retell独自のMCPサーバーを使えば、CursorやClaude Codeなどのクライアントから、API経由でエージェントを構築・管理できます。
- 自社のモデルと自社のキャリア。カスタムLLMを使う場合、Retellが通話を処理し、通話ごとに自社サーバーへのWebSocketを開きます。ドキュメントでは、ほとんどのエージェントには組み込みのエージェントタイプを推奨しており、カスタムLLMを使う場合はレイテンシ、稼働率、再接続の処理を自社で担うことになると述べています。電話回線については、カスタムテレフォニーにより、Elastic SIPトランキングまたはSIP URIへのダイヤルで接続できます。
構築済みの連携も確認しましょう。Retellの連携の概要には、CRM、サポート、カレンダー、ナレッジベースにわたる11のプロバイダーが掲載されています。このリストにないものは、カスタム関数、MCP、またはwebhookで対応します。
応答レイテンシはどう測定すべきか?
自社の通話でターンごとに測定し、定義を添えてパーセンタイルで報告します。開始点と終了点が明示されていないレイテンシの数値は、他のベンダーの数値と比較できません。
Retellのドキュメントでは、エンドツーエンドのレイテンシを、ユーザーが話し終えてからエージェントが応答を始めるまでの時間と定義しています。この定義に基づき、ドキュメントではプラットフォームが「最短600msのレイテンシを実現」すると述べています。「最短」は下限値として読んでください。実際の数値は、選択するモデル、プロンプト、設定によって変わります。
自社の数値を得るには、通話ごとに取得します。RetellのGet Call APIは、エンドツーエンドの数値と、文字起こし、LLM、音声合成、ナレッジベース検索それぞれについて、50、90、95、99パーセンタイルを含むlatencyオブジェクトを返します。同じページには制限も記載されています。エンドツーエンドの数値には、Retellのサーバーからユーザーのデバイスまでのネットワーク経路は含まれません。Webやアプリ内の通話では、クライアント側でも応答時間を計測しましょう。
数値が高い場合は、プラットフォームを疑う前に設定を確認しましょう。Retellのレイテンシのトラブルシューティングガイドでは、最も一般的な2つの原因としてLLMモデルの選択とプロンプトの長さを挙げ、約8,000 tokenを超えるプロンプトは目に見えて遅くなると述べたうえで、推定レイテンシを1.5秒未満に抑えるよう推奨しています。すべてのベンダーに同じコンポーネント別の内訳を求めましょう。
速度は良い通話を構成する要素の1つにすぎません。音声AIのレイテンシ:原因、測定、通話相手への影響では、遅延がどこから生じるのか、そしてより速い応答がかえって通話を悪化させるのはどんな場合かを解説しています。これら4つのプラットフォームの公開ベンチマーク結果については、Retell AI vs Bland AI vs Vapi vs ElevenLabsをご覧ください。
パイロットと本番規模の間で何が変わるか?
変わるのは3つです。直面する制限、障害発生時に通話相手が体験すること、そして変更がライブ通話に反映される方法です。パイロットが終わる前に、各ベンダーの回答を確認しておきましょう。
- 同時通話数。デフォルトの上限と、上限に達したときの挙動を確認します。Retellでは、従量課金のワークスペースにはデフォルトで20件の同時通話が割り当てられ、ダッシュボードから上限を引き上げられます。上限に達すると、新しい着信は空きを待ちます。約40秒経過すると、フォールバック番号を設定していればそこに転送され、設定していなければ通話は終了します。上限を超えた発信は、同時通話バースト(concurrency burst)を有効にしない限り拒否されます。これを有効にすると、分単位の追加料金が発生します。
- 稼働率とフォールバック。Retellの信頼性の概要では、99.9%を超える稼働率の保証が明記され、公開ステータスページへのリンクが掲載されています。LLMのフォールバックとリトライが組み込まれていること、また問題の調査中に新しい着信をフォールバック番号に振り向けるBackupモードがあることも記載されています。
- リリース管理。バージョン、ステージングタグ、CIパイプラインからのバッチ実行、パーセンテージによるトラフィック分割が、変更をどれだけ安全にリリースできるかを左右します。このテーマには専用のガイドがあります:音声AIの購入基準。
- セキュリティレビュー。パイロット期間中に開始しましょう。Retellのセキュリティとコンプライアンスのページによると、RetellはHIPAAおよびGDPRに準拠し、SOC 2 Type 1およびType 2の認証を取得しており、セルフサービスのBAAも提供しています。
- コストを左右する要素。Retellの料金は従量課金制で、料金ページによると1分あたり$0.07からです。料金は選択する音声、モデル、テレフォニーによって異なり、一部のレイテンシオプションは標準のモデル料金より高くなります。従量課金制の料金の仕組みで各要素を解説しています。
パイロットの設計については、本番稼働前に音声エージェントプラットフォームを評価する方法で、どの通話を含め何を測定すべきかを解説しています。また、音声AIのデモから本番へでは、最初の30日間について解説しています。
Vapi、ElevenLabs、Bland、Retellは自らをどう説明しているか?
各ベンダーのドキュメントは、いずれも音声エージェントを構築、デプロイ、モニタリングするためのプラットフォームとして説明しており、プロンプトベースで始める方法と、より構造化された選択肢を備えています。以下の表は、2026年11月10日に参照した各ベンダーのドキュメントを引用したものです。
| プラットフォーム | 公式ドキュメントでの説明 | ドキュメントに記載された構築方法 |
|---|---|---|
| Retell AI | 「テレフォニー、プロンプト、ツール、分析機能を組み込んだ、AI音声・チャットエージェントを構築、テスト、デプロイ、モニタリングするためのプラットフォーム」(Retellのドキュメント) | シングルプロンプトエージェントとカンバセーションフローエージェント |
| Vapi | 「音声AIエージェントを構築するための開発者プラットフォーム」(Vapiのドキュメント) | Assistants(単一のシステムプロンプトにツールと構造化出力を組み合わせたもの)と、Squads(コンテキストを保持した転送で複数のAssistantsを実行するもの)。音声認識、LLM、音声合成のプロバイダーを選択可能 |
| ElevenLabs | ElevenAgentsは「表現力豊かな音声モデル、マルチモーダルエージェントを構築するための開発者ツール、そしてエージェントのパフォーマンスを大規模にモニタリング・評価するためのツール」を提供(ElevenLabsのドキュメント) | 開発者ツールキット、ダッシュボード、またはビジュアルワークフロービルダー。React、Swift、Kotlin、React Native、Unity向けのSDKあり |
| Bland | 「Blandで音声AIエージェントを構築、モニタリング、改善するために必要なすべて」(Blandのドキュメント) | 「ほとんどのエージェントはシングルプロンプトから始まる」エージェントビルダー。会話に必要な箇所ではpathwaysで構造を追加 |
説明は似通っているため、読むだけでは選択できません。4つのチェックは、自社の通話タイプと自社のシステムで実施します。詳しい比較については、RetellがVapi、ElevenLabs、Blandとの比較ページと、Vapiの代替サービスのガイドを公開しています。
公平に比較するにはどうすればよいか?
プラットフォーム以外の条件はすべて一定に保ちます。通話タイプ、エンジニア、通話相手の行動を記したスクリプト、スコアカードをそれぞれ1つに絞り、すべてのベンダーで同じ項目を記入します。
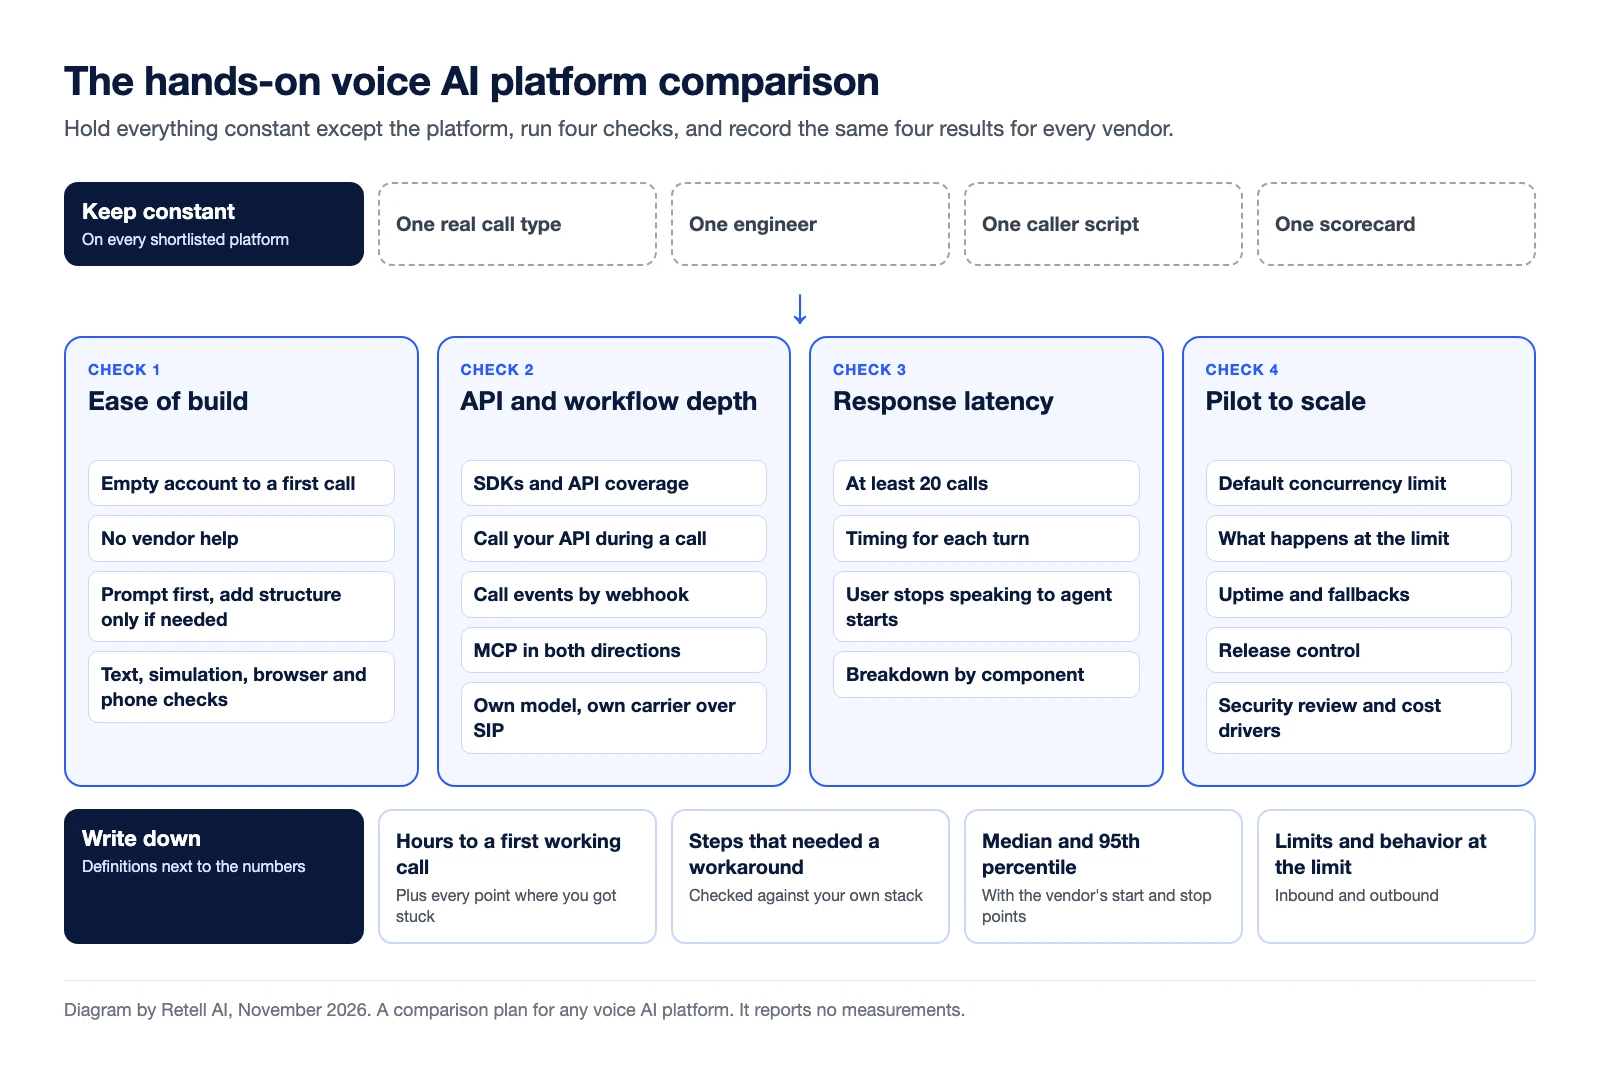
構築を始める前に、通話相手のスクリプトを書きましょう。割り込み、訂正、エージェントが断るべき質問、そして自社のAPIが必要なリクエストを1つ含めます。その後、各ベンダーの定義を数値の横に並べて、4つの結果を比較します。
選定後には、誰かがエージェントを担当する必要があります。多くのチームはその役割をCXエンジニアに任せています。CX自動化エンジニアや社内デプロイエンジニアとも呼ばれ、うまく処理されなかった通話を見つけ、修正を作成し、検証してデプロイする社内の担当者です。すでにそうした担当者がいる場合は、比較に参加してもらいましょう。エグゼクティブスポンサーがプラットフォームとベンダーに求めるものについては、CXリーダーがAI音声エージェントに求めるもので解説しています。
よくある質問
プロダクトチームは音声AIプラットフォームで何を重視すべきですか?
4つの点を、すべて実機で確認します。自社のエンジニアが最初に動作するエージェントをどれだけ早く構築できるか、API、webhook、ワークフローツールでどこまでできるか、自社の通話で通話相手が応答をどれだけ待つか、そして本番の通話量で制限や障害時の挙動がどうなるかです。候補のすべてのプラットフォームで同じチェックを実施しましょう。
音声AIプラットフォームを実機で比較するにはどうすればよいですか?
実際の通話タイプを1つ選び、1人のエンジニアに各プラットフォームで同じものを構築させ、それぞれで同じスクリプトに沿った通話を行います。最初に動作する通話までの時間、回避策が必要だったステップ、応答時間の中央値と95パーセンタイル、デフォルトの制限を記録します。各ベンダーの定義は数値の横に記載しておきましょう。
AI音声エージェントの適切な応答レイテンシはどのくらいですか?
モデル、プロンプト、設定によって変わるため、自社の通話で測定しましょう。Retellのドキュメントでは、ユーザーが話し終えてからエージェントが応答を始めるまでを測定した場合で最短600msのレイテンシを記載しており、推定レイテンシを1.5秒未満に抑えるよう推奨しています。ベンダー間でパーセンタイルを比較するのは、開始点と終了点が一致する場合に限りましょう。
AI音声エージェントの構築にエンジニアは必要ですか?
最初のエージェントには必要ありません。Retellのクイックスタートでは、ダッシュボード上でテンプレートから電話をかけるところまで進められます。エンジニアが必要になるのは、エージェントが通話中に自社のAPIを呼び出す、通話イベントを自社システムに送信する、SIP経由で自社の電話キャリアに接続する、といった場合です。これらは、プロダクトチームが比較の際に構築すべき部分です。
音声AIプラットフォームは同時に何件の通話を処理できますか?
プランとベンダーによって異なります。Retellでは、従量課金のワークスペースにデフォルトで20件の同時通話が割り当てられ、上限はダッシュボードから引き上げられます。上限に達した後、着信と発信がそれぞれどうなるかをすべてのベンダーに確認しましょう。
自社の通話で4つのチェックを実施する
Retellは、コンタクトセンター向けのAI音声エージェントプラットフォームです。シングルプロンプトエージェントとカンバセーションフローエージェント、型付きSDK、カスタム関数、webhook、MCP、カスタムテレフォニー、通話ごとのレイテンシデータを備えています。4,000社以上の顧客がRetell上で月間1億件以上の通話を処理しており、Retellは2026年11月に年間ランレート$100Mを達成しました。料金は従量課金制で、料金ページによると1分あたり$0.07からです。他社で構築したものと同じエージェントを構築し、自社の通話で運用して、契約前に数値を比較しましょう。
AI搭載の音声エージェントに切り替えることで、あなたのビジネスがどれだけ節約できるかをご確認ください。
ROI結果
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Retellで、電話業務に革命を


