GPT-Live-1:OpenAIのフルデュプレックス音声モデルは電話でどう機能するか




GPT-Live-1は、OpenAIのフルデュプレックス音声モデルです。聞きながら同時に話すことができ、割り込みにも自ら対応し、推論とツール利用は別のバックエンドモデルに任せます。OpenAIはChatGPTの音声モードでデビューさせた後、2026年9月10日にAPIで提供を開始しました。また、2026年11月2日からRetell AIの電話エージェントで利用可能になっています。本ガイドでは、その仕組み、APIでの料金、電話での活用場面、そしてRetellエージェントでの設定方法を解説します。
本ガイドはRetell AIが公開しており、Retell AIは自社の音声エージェントプラットフォームで利用できるモデルの1つとしてGPT-Live-1を提供しています。
GPT-Live-1の概要
| GPT-Live-1 | |
|---|---|
| 開発元 | OpenAI |
| モデルID | gpt-live-1 |
| 種類 | 推論とツール利用をバックエンドモデルまたはエージェントに委任するフルデュプレックス音声モデル |
| 入力と出力 | 音声とテキストを入力し、音声とテキストを出力 |
| APIエンドポイント | Liveセッション(v1/live/sessions)。WebRTC、WebSocket、または電話回線とSIP経由 |
| API料金 | 音声セッション1分あたり$0.05、秒単位で課金。バックエンドモデルとツールの利用は別途課金。 |
| 同時接続数 | Buildティアで50セッション、Launchで300、Growで500。Freeティアでは利用不可。 |
| コンテキストウィンドウ | 128,000 token |
| 新しいバージョン | GPT-Live-1.1は2026年10月15日にChatGPT、Codex、dotsに展開され、APIにも近日提供予定と発表されました。11月5日時点ではAPIでは未提供です。 |
出典:OpenAIのGPT-Live-1モデルページ、Liveガイド、Live conversationsガイド、APIチェンジログ、ローンチ記事。GPT-Live-1.1についてはOpenAI開発者フォーラムの投稿より。2026年11月5日閲覧。
フルデュプレックスの仕組み
多くの音声エージェントは、2つの方法のいずれかでターンを交代します。カスケード型エージェントは通話相手の音声を文字起こしし、そのテキストを言語モデルに送り、返答を音声に変換します。OpenAIのgpt-realtime-2.1のような音声対音声(speech-to-speech)モデルは、この3つを1つのモデル内で行います。
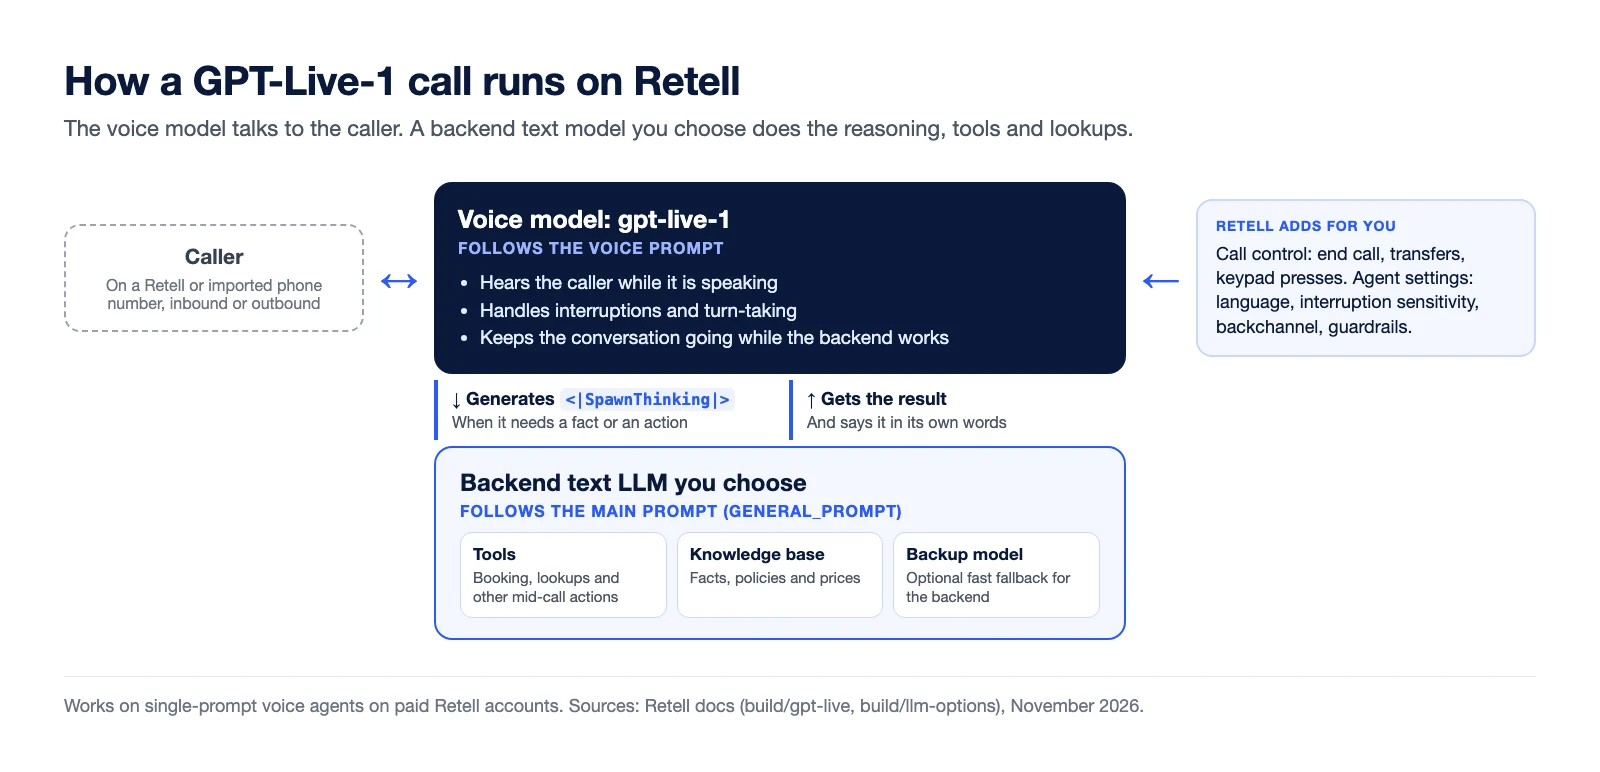
GPT-Live-1は役割分担が異なります。音声モデルが会話を担い、自分が話している間も通話相手の声を聞き、割り込み(バージイン)や間に対応し、次に何を話すかを決めます。事実の確認やアクションが必要になると、特殊なtoken「<|SpawnThinking|>」を生成してバックエンドに処理を依頼します。バックエンドはモデル、エージェント、サービスのいずれでもよく、Retellでは任意に選んだテキストモデルが、エージェントのツールとナレッジベースを実行します。バックエンドが結果を返すと、音声モデルがそれを自分の言葉で伝えます。通話相手が割り込んでも、バックエンドの処理は継続できます。
この分担の有効性は、OpenAI自身の数値が示しています。APIローンチ記事のグラフによると、推論努力を中(medium)に設定したGPT-6 Astraをバックエンドに使用したGPT-Live-1は、Tau3の音声タスク(航空会社、小売、通信のサポート)の86.2%を初回で達成し、GPT-Realtime-2.1の45.7%を上回りました。Full Duplex Benchでは、OpenAIはGPT-Live-1のターンテイキングのレイテンシ(遅延)を0.798秒と報告しており、GPT-Realtime-2.1は1.41秒です。これらはOpenAIによる結果であり、Retellの測定値ではありません。
カスケード型、音声対音声、フルデュプレックスのどれを選ぶか
Retellは音声エージェントを動かす3つの方式すべてに対応しています。それぞれ適した通話が異なります。
| カスケード型 | 音声対音声 | フルデュプレックス(GPT-Live-1) | |
|---|---|---|---|
| ターンの仕組み | 文字起こし→テキストLLM→音声合成 | 1つのモデルが音声を聞き、音声で応答 | バックエンドのテキストLLMが推論とツールを担う間、音声モデルが会話 |
| Retellでの例 | GPT 5.6 Terra、Claude 5 Sonnet、Gemini 3.5 Flash | gpt-realtime-2.1、grok-voice-3.0 | gpt-live-1とバックエンドのテキストLLM |
| prompt数 | 1つ | 1つ | 2つ:音声promptとバックエンドprompt |
| 高速フォールバック用バックアップモデル | 対応 | 非対応 | バックエンドモデルに適用 |
| 最適な用途 | 会話フローと厳密な複数ステップのロジック | 主に1つのpromptに従う、高速で自然な通話 | 通話中にアクションも実行する自然な通話 |
xAIの音声対音声オプションについては、Grok Voiceで電話エージェントを動かす方法をご覧ください。より幅広いモデルについては、電話向け音声対音声AI APIの比較をご覧ください。
電話でGPT-Live-1が適している場面
GPT-Live-1が最も力を発揮するのは、予約の受付や注文の照会など、通話中にアクションを実行するシングルpromptエージェントで、カスケード型エージェントでは応答の間が目立つような場面です。バックエンドが予約や検索を行っている間も、音声モデルはつなぎのセリフで止まることなく会話を続けます。
Retellでは、次のような明確な制限があります。
- シングルprompt音声エージェントのみ。会話フロー、マルチpromptエージェント、転送エージェント、チャットエージェントでは利用できません。これらにはカスケード型または音声対音声モデルを使用してください。
- 一部のツールは非対応です。エージェントスワップ、ウォームトランスファー(事前取次・ブリッジ転送)、転送キャンセルは保存時に拒否されます。通常の通話転送、通話終了、数字入力(press digit)はすべて動作します。
- 有料アカウントのみ。音声対音声モデルと同様に、GPT-Live-1は無料トライアルの対象外です。
- 通話ごとの切り替えは不可。単一通話でのエージェントオーバーライドでは、エージェントをGPT-Live-1に切り替えることはできません。
Retellの電話エージェントでGPT-Live-1を設定する方法
GPT-Live-1は、Retell APIを通じてRetell LLM上で設定します。
- Retell LLMを作成します。model_configのtypeをduplexに設定し、プライマリモデルにgpt-live-1、バックエンドに任意のテキストモデルを指定します。
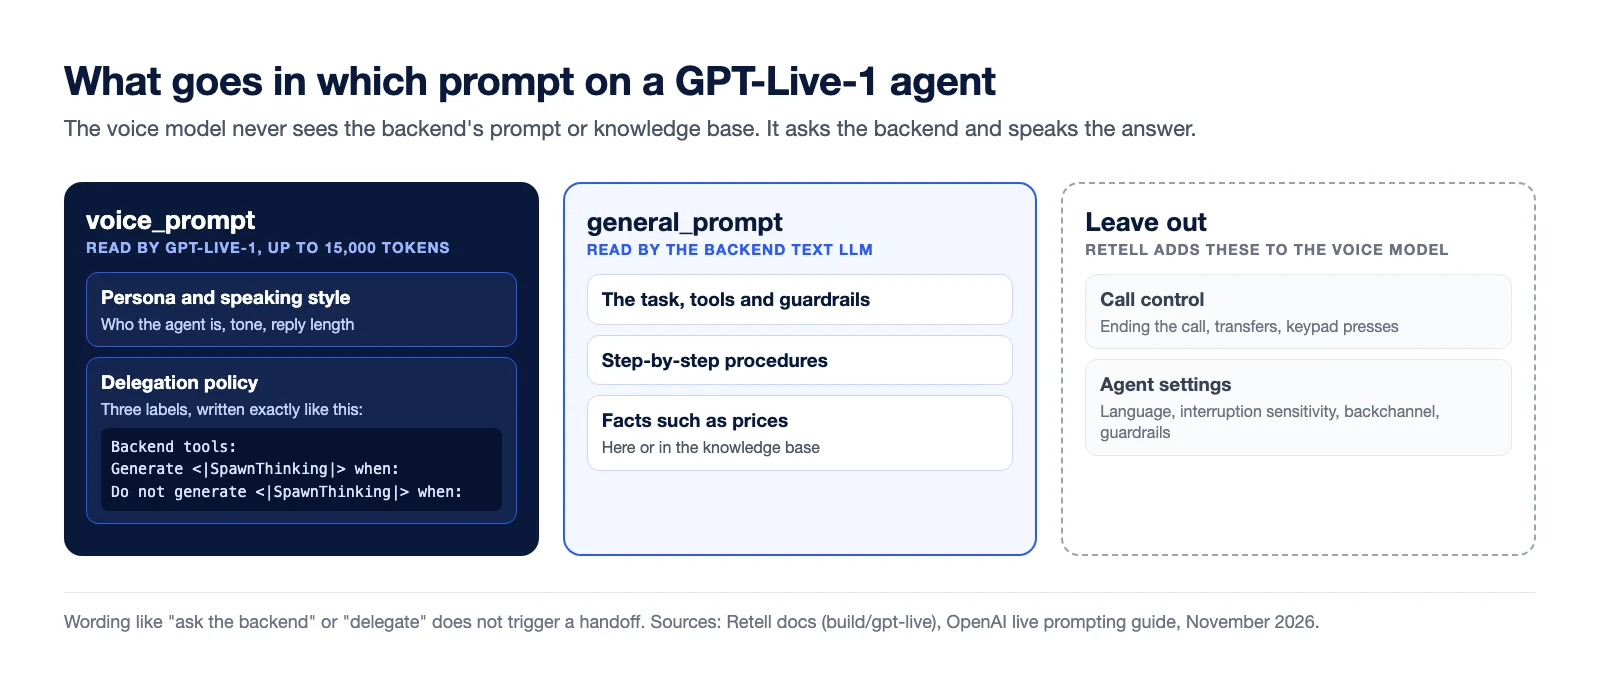
- 2つのpromptを作成します。general_promptはバックエンド用のpromptで、タスク、ツール、ガードレールを記述します。voice_promptは、音声モデルの話し方と、バックエンドに処理を任せるタイミングを指示します。最大15,000 tokenまで記述できます。
- LLMを音声エージェントに接続します。他のRetell LLMと同様に、レスポンスエンジンとして設定します。
- 電話番号を接続し、着信を受けたり発信したりします。
以下は、Retellのドキュメントを歯科医院向けエージェント用に改変したリクエスト例です。
curl --request POST "https://api.retellai.com/create-retell-llm" \
  --header "Authorization: Bearer $RETELL_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "general_prompt": "You are the backend for a dental clinic phone agent. Collect the caller name and date of birth, then use the booking tool to find and confirm an appointment. Keep names, numbers, and dates exact.",
    "voice_prompt": "You are a warm, efficient front-desk agent for Bright Smile Dental. Keep replies short and natural, and ask one question at a time.\n\nDelegation policy:\nBackend tools:\n- Appointments: find open times and book, change, or cancel appointments.\n\nGenerate <|SpawnThinking|> when:\n- The caller wants to book, change, or cancel an appointment.\n\nDo not generate <|SpawnThinking|> when:\n- You need a brief clarification to understand the request.",
    "model_config": {
      "type": "duplex",
      "primary": { "model": "gpt-live-1" },
      "backend": { "model": "gpt-4.1" }
    }
}'各フィールドの詳細はGPT Liveセットアップガイドをご覧ください。
音声promptの書き方
GPT-Live-1エージェントで最もつまずきやすいのが音声promptです。モデルは<|SpawnThinking|>を生成したときにのみバックエンドへ処理を渡すため、引き継ぎのルールにはこの表現を正確に使う必要があります。「バックエンドに聞く」や「委任する」といった表現では引き継ぎは発生しません。OpenAIのpromptingガイドでも、「確認しています」のような口頭の約束をしても、バックエンドの処理が始まったことにはならないと注意を促しています。
音声promptは2つのパートで構成します。
- ペルソナと話し方。トーンや返答の長さなど、エージェントが誰で、どのように話すかを記述します。
- 委任ポリシー。次の3つのラベルを書かれたとおり正確に使います。「Backend tools:」にはバックエンドができることを1行に1つずつ列挙します。「Generate <|SpawnThinking|> when:」には引き継ぐタイミングを列挙します。「Do not generate <|SpawnThinking|> when:」には直接答える内容を列挙します。
ツール定義、手順、価格などの事実は、バックエンドpromptとナレッジベースに記載します。音声モデルはそれらを参照できず、バックエンドに問い合わせて回答を自分の言葉で伝えます。また、Retellが通話制御の指示(通話終了、転送、キーパッド入力)とエージェント設定を音声モデルに自動で追加するため、これらは記載不要です。
エージェント設定から引き継がれるもの
Retellのエージェント設定の大半は引き続き適用されます。音声モデルは、エージェントの言語、割り込み感度、応答性、相づち(バックチャネル)、音声速度、発音、ブーストキーワード、ガードレールを反映します。留守番電話、IVR、発信拒否(do-not-call)、コールバックの検出はバックエンドで実行され、ウェルカムメッセージの設定によって引き続きどちらが先に話すかが決まります。
異なる動作をする点が2つあります。各ツールの「実行中に話す(speak during execution)」設定は無視されます。音声モデルはバックエンドの実行中も話し続け、ツールの完了後には必ずエージェントが話すためです。音声prompt内の動的変数は、通話開始時に一度だけ値が入ります。
GPT-Live-1の料金
OpenAIのAPIでは、GPT-Live-1の音声セッションは1分あたり$0.05で、秒単位で課金され、次の分に切り上げられることはありません。バックエンドモデルとそのツールは、通常料金で別途課金されます。
Retellでは、音声モデルは通話時間1分ごとに課金され、バックエンドのテキストLLMはその利用量に応じて別途課金されます。最新の料金は料金ページをご覧ください。長時間の通話では1点注意が必要です。Retellは長い無音区間のモデル料金を減額しますが、フルデュプレックス音声モデルは無音区間中も課金されます。
よくある質問
GPT-Live-1とは何ですか?
GPT-Live-1は、リアルタイム会話向けのOpenAIのフルデュプレックス音声モデルです。聞きながら同時に話し、割り込みに対応し、推論とツール利用を任意に選んだバックエンドモデルまたはエージェントに委任します。
GPT-Live-1はAPIで利用できますか?
はい。GPT-Live-1は2026年9月10日に、OpenAIのAPIのLiveセッションエンドポイントで一般提供が開始されました。より多くの音声と英語以外の言語での性能向上を備えた新バージョンGPT-Live-1.1は、2026年10月15日にChatGPT、Codex、dotsに展開され、APIにも近日提供予定と発表されています。
GPT-Live-1の料金はいくらですか?
OpenAIはGPT-Live-1の音声セッションに1分あたり$0.05を課金し、秒単位で請求します。バックエンドモデルとツールの利用は、通常料金で別途課金されます。
GPT-Live-1は電話に対応できますか?
はい。OpenAIはLiveセッションで電話回線とSIP接続をサポートしています。RetellではGPT-Live-1エージェントも他の音声エージェントと同じように扱えるため、電話番号に接続して着信・発信に利用でき、通常の通話転送と数字入力(press digit)も動作します。
GPT-Live-1とgpt-realtimeの違いは何ですか?
gpt-realtimeモデルは音声対音声型で、OpenAIのRealtime API上で1つのモデルが聞き取り、推論、ツール呼び出し、発話を行います。GPT-Live-1は別のLiveセッションエンドポイントで動作し、音声は専用のモデルで扱い、推論とツールはバックエンドに送ります。OpenAIは、強力なバックエンドと組み合わせたGPT-Live-1のほうがタスク完了率が高く、ターンテイキングも速いと報告しています。
RetellでGPT-Live-1は会話フローに対応していますか?
いいえ。RetellではGPT-Live-1はシングルprompt音声エージェントでのみ動作します。会話フローとマルチpromptエージェントには、カスケード型または音声対音声モデルが必要です。
実際の通話でGPT-Live-1を試す
エージェントが通話中にアクションを実行し、その間の沈黙が気になっているなら、GPT-Live-1は試験導入する価値があります。セットアップガイドに従い、Retellで電話番号を接続し、切り替える前に実際の通話で現在のモデルと比較してみてください。
AI搭載の音声エージェントに切り替えることで、あなたのビジネスがどれだけ節約できるかをご確認ください。
ROI結果
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Retell クリニックオフィスのデモ電話番号
What results look like with Retell AI


Estimate your monthly voice AI cost
Retellで、電話業務に革命を


