音声AIの選定基準は変わった:自然な話し方から、迅速かつ安全な改善へ




音声AIの評価基準とは、音声エージェントプラットフォームが自社の電話回線で問題なく機能するかを、購入者が判断するためのテストです。かつては、自然に聞こえる音声が決め手でした。今ではそれは最低条件にすぎません。候補に残ったどのベンダーも通話で良好に聞こえるようになると、決め手は別のところに移ります。チームがエージェントをどれだけ速く、そしてどれだけ安全に変更できるかです。
購入検討の場では、ある傾向が見られます。評価の第1ラウンドでは、音声、レイテンシ、割り込みへの対応を比較します。第2ラウンドで問われるのは、40日目に何が起きるかです。ポリシーが変わったとき、アウトバウンドキャンペーンに新しいスクリプトが必要になったとき、あるいは新しいモデルがリリースされたときです。変更プロセスのライブデモでこうした質問に答えられないベンダーは、立ち上げだけを売り、運用はお客様任せにしています。
本ガイドは、音声エージェントプラットフォームを提供するRetell AIが公開しています。ここで紹介する質問は、当社を含むどのベンダーにも使えます。当社のドキュメントに記載された回答に限界がある箇所は、その旨を明記しています。
なぜ自然な話し方だけではベンダーを選べないのか?
音声品質が左右するのはエージェント稼働後の最初の1週間で、その後を左右するのは変更だからです。自社の通話でエージェントが適切に聞こえるかどうかは、引き続き確認が必要です。パイロットでのレイテンシ、割り込み、文字起こし、転送の確認方法は、本番稼働前に音声エージェントプラットフォームを評価する方法で解説しています。しかし、音声エージェントに完成はありません。発信者はスクリプトが想定していない言い回しをしますし、価格やポリシーは変わり、新しい種類の電話も入ってきます。
こうした変更はどれも、電話回線上での本番リリースです。誰かが文字起こしを読む前に、不適切な一文が実際の発信者に届いてしまいます。だからこそ基準はスピードと安全性の2つで構成され、両方を評価する必要があります。
ソフトウェアチームは、すでにこの考え方でデリバリーを測定しています。Google Cloudが運営する研究プログラムDORAは、ソフトウェアデリバリーのパフォーマンスをスループットと不安定性に分けて捉えています。変更がどれだけ速く本番環境に届くか、そしてどれだけの頻度でロールバックやホットフィックスが必要になるかです。DORAは「スピードと安定性はトレードオフではない」と報告しており、ほとんどのチームでこれらの指標には相関があります。エージェントを速く変更するか安全に変更するか、どちらかを選ぶようベンダーに求められるべきではありません。
ベンダーはどの変更で評価すべきか?
一般的な「使いやすさ」の評価ではなく、実際に行う変更で評価しましょう。変更の種類ごとにリスクが異なるため、それぞれについて個別に確認してください。
| 変更 | 例 | 「速い」の目安 | 「安全」の目安 |
|---|---|---|---|
| プロンプトの文言 | 返金ポリシーの言い回しを変える | エージェントの担当者がエンジニアなしで編集できる | 発信者に届く前に、番号付きのバージョン、差分の表示、テスト実行がある |
| ナレッジコンテンツ | 新しい価格表や営業時間 | ソースを一度更新するだけで済む | 更新がいつ実際の回答に反映されるかがわかる |
| 会話フロー | 新しい問い合わせ理由への分岐を追加する | ビルダーでフローを編集できる | 共有部分の変更が、他のエージェントを予期せず変えない |
| モデル | より新しい、または安価なLLMへ移行する | プロンプトの書き直しが不要 | 切り替え前に、同じテストスイートを両方のモデルで実行する |
| アウトバウンドキャンペーン | キャンペーン途中で新しいスクリプトにする | キャンペーンが使うエージェントバージョンを差し替えられる | 下書きが誤って実際の発信に使われることがない |
| 音声またはあいさつ | 新しい音声や冒頭のひと言 | 設定で変更できる | リリース前に、誰かが通話で実際に聞いて確認する |
本ガイドの残りでは、この表を質問に落とし込みます。プラットフォームを選んだ後の実践的なリリースプロセスについては、音声エージェントの変更をテストしてリリースする方法をご覧ください。
改善のスピードについて何を確認すべきか?
誰が変更でき、実際の修正にどれくらいかかるかを尋ね、ベンダーに実演してもらいましょう。
- 自社チームの誰がエージェントを変更できますか?エンジニアは必要ですか?回答では、ベンダーのサービスチームではなく、自社側の役割が挙げられるべきです。Retellのアクセス制御では、エージェントの構築・テスト・編集ができるロールと、閲覧専用のMemberロールが分かれています。
- 失敗した通話から、実際の通話に修正が反映されるまでどれくらいかかりますか?見積もりで済ませてはいけません。パイロットで失敗した通話、できれば既知の音声エージェントの失敗パターンに当てはまる通話を選び、自社の担当者に目の前で修正・確認・リリースしてもらいましょう。
- 複数の修正案を同時に試せますか?Retellのエージェントバージョンでは、過去のどのバージョンからでも下書きを作成でき、複数の下書きを同時に保持して異なるアプローチを試せます。
- 失敗した通話を、手作業で書き起こさずにテストケースにできますか?Retellでは、ConductorがCall HistoryやAI QAの通話をシミュレーションのテストケースに変換し、ペルソナと成功基準の草案を作成します。ただしドキュメントでは、各ケースを必ずレビューし、実際のendpointにアクセスする関数はモックにするよう注意を促しています。
- 回帰テストスイートを自社のパイプラインから実行できますか?RetellのバッチテストAPIはバッチを開始し、ポーリングすると成功・失敗・エラーの件数を返します。そのため、CIジョブでデプロイ前に結果を確認できます。
- モデルを変更すると書き直しが必要ですか?シングルプロンプトおよびマルチプロンプトのエージェントについて、Retellのドキュメントでは、プロンプトを書き直さずに後からモデルを切り替えられるとしています。
- 改善にはどれくらいのコストがかかりますか?Retellでは、テストは本番と同じ料金で課金されます。テキストテストはメッセージ単位、Webテストと電話テストは分単位です。あらかじめ予算を確保しておきましょう。再実行する余裕のないテストスイートは、結局再実行されないからです。
改善の安全性について何を確認すべきか?
リリース前に変更をどう隔離するか、リリース後にどう段階的に公開するか、そしてどれだけ速く元に戻せるかを尋ねましょう。
- すべての変更は、後から戻れる固定バージョンになりますか?Retellでは、下書きのエージェントバージョンを公開すると読み取り専用になり、「後から戻れる固定の設定」が得られます。この考え方はプロンプトのバージョン管理で解説しています。
- 何が変わったかを正確に確認できますか?Retellのバージョン比較では、2つのバージョンを並べて表示し、長いプロンプトテキストの単語レベルの差分や、紐づくナレッジベースと関数の変更を確認できます。
- すべての発信者に届く前に、一部の発信者だけに変更を適用できますか?GoogleのSRE Workbookは、カナリアリリースを「サービスにおける変更の、部分的かつ期間限定のデプロイとその評価」と定義しています。Retellでは、A/Bテストにより、電話番号のインバウンドまたはアウトバウンドのトラフィックをエージェント間でパーセンテージ単位で分割できます。また、各エージェントには最初からprodとstagingの環境タグがあるため、stagingを新しいバージョンに向け、まずテスト番号に電話して確認できます。
- どのようにロールバックしますか?すべての番号が追従しますか?Retellでは、prodタグを以前のバージョンに戻すと、そのタグに紐づく番号が追従します。バージョンに直接割り当てられた番号はそのバージョンのままになるため、どの番号がタグを使っているかを確認する方法を尋ねましょう。
- 変更で状況が悪化したことは、何でわかりますか?Retellのアナリティクスダッシュボードでは、エージェントバージョンごとに指標を確認できます。アラートルールは環境タグに限定して前回のサイクルと比較でき、AI QAは通話のサンプルを採点してハルシネーションなどの問題を検出します。
次に、多くの評価で見落とされがちな質問をしましょう。どの変更がリリース経路を迂回するのか?どのプラットフォームにも、そうした変更は何かしらあります。それを自ら明示するベンダーのほうが、「ない」と主張するベンダーよりも安全に運用しやすいのです。以下は、ドキュメントに記載されているRetellの例です。
- 共有サブフロー。ライブラリサブフローは複数のエージェントで共有され、編集内容は公開済みバージョンも含め、それを使うすべてのエージェントに反映されます。これを防ぎたい場合は、公開前にローカルサブフローに変換するようドキュメントで案内されています。
- 自動更新されるナレッジ。自動更新をオンにすると、ナレッジベースは24時間ごとにURLソースを再取得し、変更された連携ファイルを再同期します。そのため、ソースページの編集が新しいエージェントバージョンを経由せず、次回の更新時に回答へ反映される場合があります。
- 最新の下書きに設定されたキャンペーン。キャンペーンのステップでは、固定バージョン、最新の公開バージョン、タグ、または最新作成バージョンを使用できます。Dialerのドキュメントでは、Latest Createdを使わないよう警告しています。編集中の下書きが、次回の発信で実際の通話に使われてしまうためです。
アウトバウンドキャンペーンとモデル変更には、別の質問が必要か?
はい。どちらも、プロンプトの編集とは異なる形で実際の通話を変えるからです。
キャンペーン。実行中のアウトバウンドキャンペーンは、1つのエージェントに対して今後の通話が多数待機している状態です。各発信でどのバージョンが使われるか、キャンペーン開始後に何を変更できるかを尋ねましょう。RetellのDialerは、開始時ではなく発信のたびにエージェントバージョンを決定します。そのため、固定バージョンを指定すればキャンペーン全体を通してエージェントが安定し、Latest Publishedを指定すれば公開された変更がキャンペーンに反映されます。シーケンスと連絡先リストは開始時に固定され、変更するにはキャンペーンを複製する必要があります。一時停止すると約1分以内に新規発信が止まり、すでに発信済みの通話はそのまま最後まで続きます。
モデル。モデルの変更は、言い回し、ツール呼び出し、タイミングを一度に変える可能性があります。同じテストスイートを旧モデルと新モデルの両方で実行できるか、高速なバックアップモデルを稼働させられるかを尋ねましょう。Retellが管理するモデルを使う音声エージェントでは、RetellのLLM設定で、プライマリモデルと並行して動作する高速なfallbackモデルを利用できます。ドキュメントでは、デプロイ前に両方のモデルが指示に従い、ツールを正しく呼び出すことを確認するよう案内しています。また、temperatureを変更した後は、指示とツール呼び出しを再テストするよう記載されています。
迅速かつ安全な改善について、ベンダーをどう評価するか?
パイロット期間中、候補に残ったすべてのプラットフォームで同じ4つのドリルを実施しましょう。作業はエージェントを担当する予定の人が行い、それぞれの所要時間を計測します。
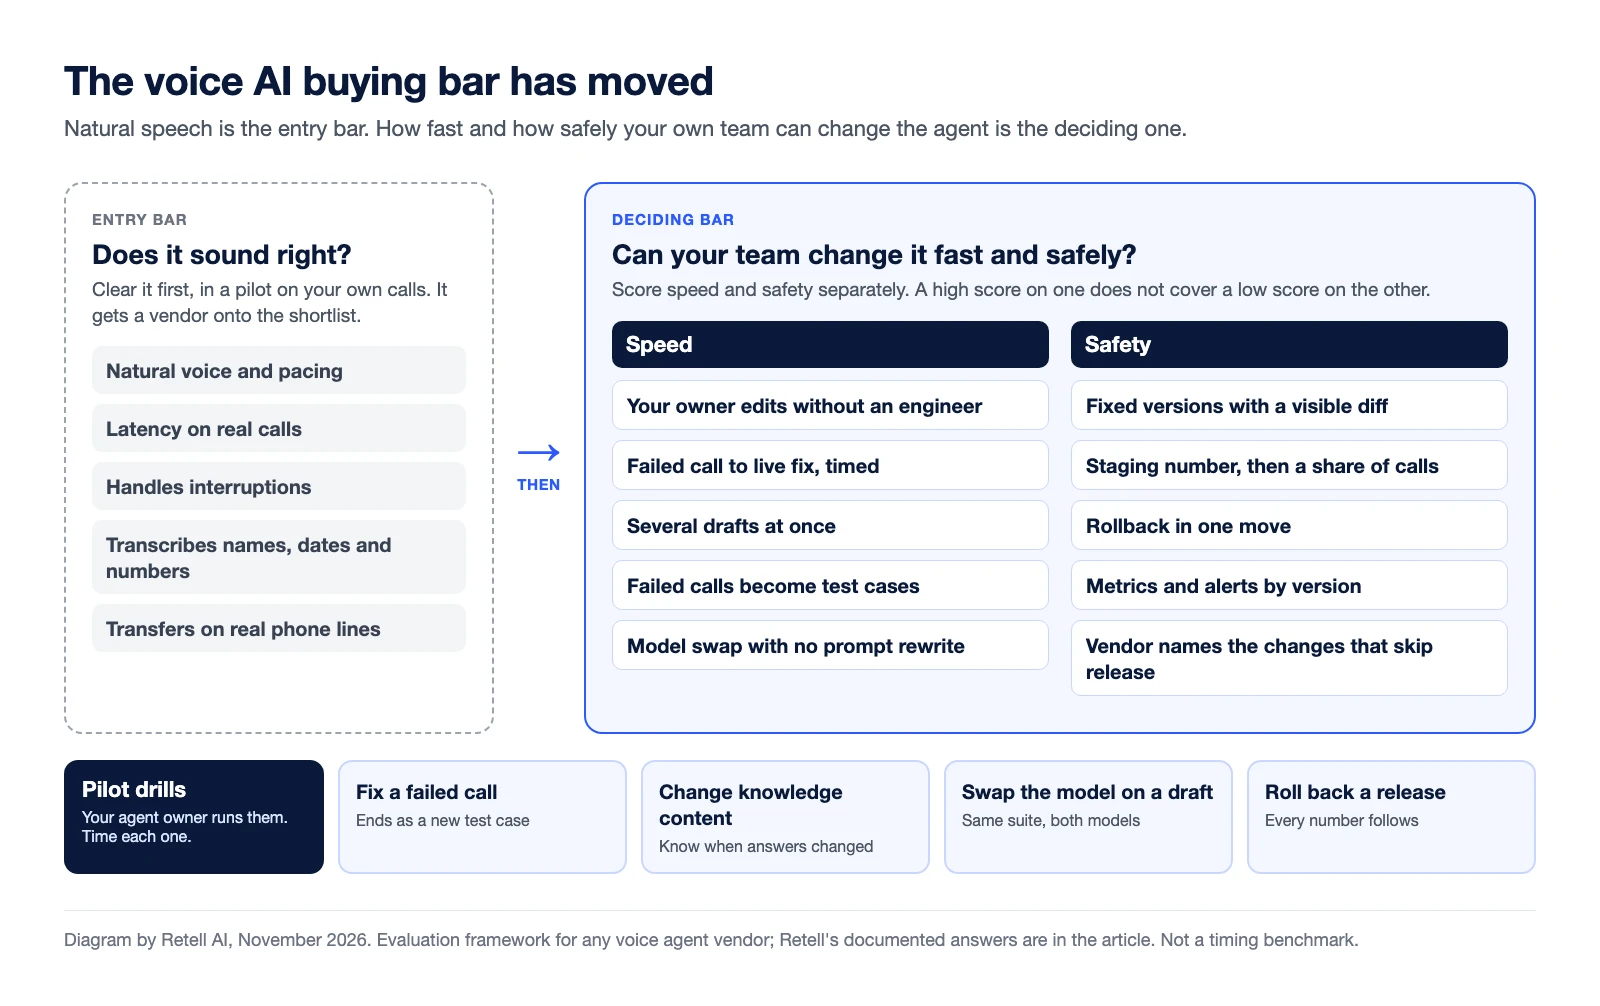
| ドリル | 記録する内容 | 合格の基準 |
|---|---|---|
| 失敗した通話を修正する | 通話を見つけてから、ステージング番号で修正が動作するまでの時間 | 担当者がベンダーの支援なしで実施でき、失敗した通話がテストケースになっている |
| ナレッジコンテンツを変更する | 変更がいつ実際の回答に反映されたか、またどのように確認したか | どの通話が旧コンテンツを聞き、どの通話が新コンテンツを聞いたかを説明できる |
| 下書きでモデルを切り替える | 同じテストスイートの、両モデルでの合格率 | 書き直しなしでスイートを再実行でき、その結果で切り替えを判断できる |
| 問題のあるリリースをロールバックする | 判断してから、すべての本番番号が以前のバージョンに戻るまでの時間 | ワンステップで完了し、どの番号が追従したかを示せる |
スピードと安全性はそれぞれ1〜5で個別に評価し、一方の高得点でもう一方の低得点が隠れないようにしましょう。修正を1時間でリリースできても、ロールバックできないプラットフォームは不合格です。すべての変更が安全でも、ベンダーへのチケット起票が必要なプラットフォームも同様です。両方を同時に改善するためのDORA自身のアドバイスは、変更を小さく保つことです。「変更が小さければ、障害が起きたときの復旧も容易になります。」
関連する判断については、別のページで解説しています。自社開発するか、購入するか、マネージドサービスを使うかによって、そもそも誰がこれらのドリルを実施するかが決まります。詳しくはAI音声エージェントの自社開発と購入の比較をご覧ください。導入の費用対効果についてはAI音声エージェントのROIで解説しています。このスコアカードは両方が決まっていることを前提に、チームがエージェントを継続的に改善できるかどうかだけを問うものです。どの通話から自動化するかは別の判断であり、音声AIのユースケースの選び方で取り上げています。
よくある質問
音声AIプラットフォームを評価する際、最も重要な基準は何ですか?
まず、自社の通話でワークフローを最後まで完了できるか、電話システムやデータシステムに適合するか、自然に聞こえるかを確認します。候補ベンダーがそれらを満たしたら、差がつく基準は改善力です。チームがプロンプト、ナレッジ、フロー、キャンペーン、モデルをどれだけ速く変更でき、その変更がどれだけ安全に実際の発信者に届くかです。
ベンダーのプラットフォームで音声エージェントをどれだけ速く変更できるかは、どうテストしますか?
パイロットで失敗した通話を選び、エージェントを担当する予定の人に、修正、確認、テスト番号へのリリース、ロールバックまでを行ってもらい、その時間を計測します。ナレッジの変更と、下書きでのモデル切り替えでも同じことを繰り返します。ベンダーのスタッフによる録画デモは評価の対象外です。
音声エージェントの変更を安全にするものは何ですか?
安全な変更とは、差分を表示できる固定バージョンであり、リリース前に保存済みのテストスイートに合格し、まず一部の通話にだけ届き、ワンステップでロールバックできるものです。また、共有コンポーネントや自動更新されるナレッジなど、その経路を迂回する変更も把握しておく必要があります。
パイロット中の改善ドリルは、誰が実施すべきですか?
ベンダーのチームではなく、稼働後にエージェントを担当する人です。この役割をCX自動化エンジニアに任せるチームもあります。うまく処理されなかった通話を見つけ、修正を作成し、確認してデプロイする社内の担当者です。
音声エージェントの背後にある言語モデルを、作り直さずに変更できますか?
多くのプラットフォームで可能ですが、検証せずに切り替えるべきではありません。同じテストスイートを両方のモデルで実行して結果を比較し、新しいモデルはまず一部の通話にリリースしましょう。Retellのシングルプロンプトおよびマルチプロンプトのエージェントでは、プロンプトを書き直さずに後からモデルを切り替えられるとドキュメントに記載されています。あわせて、fallbackモデルが指示に従うことを確認し、temperatureを変更した後はツール呼び出しを再テストするよう案内されています。
改善力を評価スコアカードに加えましょう
音声AIの選定基準は、「人間のように聞こえるか」から「通話を壊さずに素早く変更できるか」へと移りました。Retellはコンタクトセンター向けのAI音声エージェントプラットフォームです。下書きバージョン、バージョン比較、環境タグ、シミュレーションテストとバッチテスト、A/Bトラフィック分割、AI QAを備えており、エージェントの担当者はベンダーを待たずに変更をテスト、リリース、ロールバックできます。料金は従量課金で、1分あたり$0.07からです。詳しくは料金ページをご覧ください。パイロットには最も難しい変更を持ち込み、その所要時間を計測してください。
AI搭載の音声エージェントに切り替えることで、あなたのビジネスがどれだけ節約できるかをご確認ください。
ROI結果
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Retell クリニックオフィスのデモ電話番号
What results look like with Retell AI


Estimate your monthly voice AI cost

Retellで、電話業務に革命を


