インターリーブ推論(interleaved reasoning)とは、推論モデルの実行方法の一つです。モデルは応答する前にすべての推論を終えるのではなく、非公開の推論と、ツール呼び出しや回答の一部といった可視のアクションとを交互に行います。
インターリーブ思考(interleaved thinking)とも呼ばれます。ベンダーのドキュメントでは、主にツール呼び出しの間に行う推論を指してこの用語が使われます。研究論文では、思考と回答の一部を交互に行うモデルを指して使われます。どちらも同じ変化を表しています。推論が、ターンの冒頭にある単一のブロックではなくなるということです。
推論モデルとは?
推論モデルとは、回答の前に中間的な推論を生成する大規模言語モデルです。OpenAIの推論ガイドは、これを「推論モデルは、応答を生成する前に内部の推論トークンを使用します」と一言で説明しています。GoogleのGeminiドキュメントは、思考モデルは「応答する前に内部で推論する」と説明しています。DeepSeekのドキュメントは、その思考モードが「最終応答の精度を高めるために」chain-of-thought推論を生成すると述べています。
推論トークンとは?
推論トークン(思考トークンとも呼ばれます)は、モデルが問題を検討する過程で生成するトークンです。回答の一部ではありません。重要な特性は3つあります。
- 課金対象です。OpenAIは、推論トークンは「出力トークンとして課金される」としています。Anthropicの思考に関するドキュメントも、Claudeについて「思考テキストが返されない場合でも」同様に課金されると述べています。Googleは応答の料金を「出力トークンと思考トークンの合計」で算出します。
- 多くの場合、非表示です。OpenAIの推論トークンは「APIからは見えません」。Anthropicは、表示される内容は「決して生のchain of thoughtではない」としています。どちらも、リクエストすれば要約を返すことができます。
- 時間と容量を消費します。OpenAIによると、モデルは1回のリクエストで「数百から数万の推論トークン」を生成する場合があり、それらはコンテキストウィンドウを占有します。
開発者は設定で推論の量を制御します。OpenAIではreasoning effort、Anthropicではeffort、Googleではthinking levelです。
インターリーブ推論は思考先行型の推論とどう違うのか?
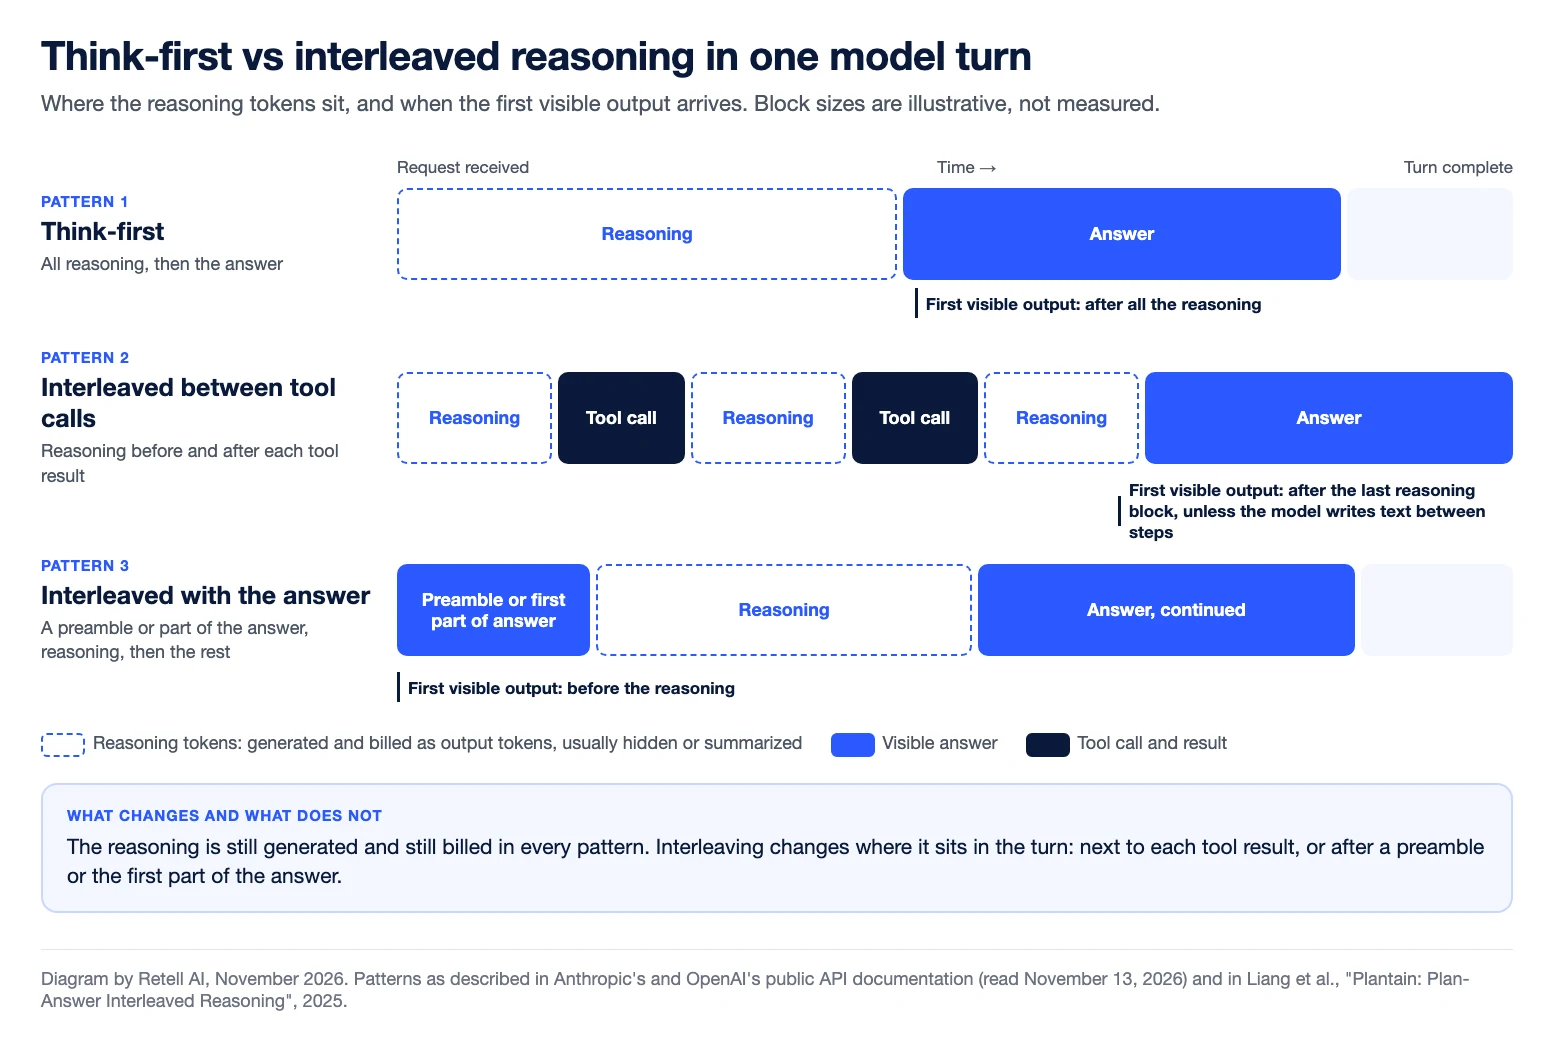
思考先行型(think-first)の推論では、すべての推論が最初の可視トークンより前に行われます。Anthropicはこれをup-front thinkingと呼び、思考ブロックは「テキストブロックより前に届く」としています。インターリーブ推論は、推論を小さなブロックに分割し、必要な箇所に配置します。
| パターン | 1ターン内の処理順序 | ユーザーが最初に目にするもの | 公開資料での説明元 |
|---|---|---|---|
| 推論なし | 回答 | 回答の冒頭 | 推論をオフにしたすべてのモデル |
| 思考先行型 | すべての推論を行い、その後に回答 | 推論が終わるまで何も表示されない | Anthropic(up-front thinking)、DeepSeek |
| ツール呼び出し間のインターリーブ | 推論し、ツールを呼び出し、結果を読み、再び推論してから回答 | 最後の推論ブロックが終わるまで何も表示されない(モデルがステップ間でテキストを書く場合を除く) | Anthropic、OpenAI、vLLM、DeepSeek(この用語は使用せず) |
| 回答とのインターリーブ | 前置きまたは回答の一部、推論、回答の続き | 前置き、または回答の前半部分 | OpenAI、研究論文 |
| 音声とのインターリーブ | 返答の最初の文、その再生中に行う無音の推論、返答の残り | 返答の最初の文 | Tell-1(Retell独自のLLM) |
現在、各ベンダーはどのように説明しているか?
2026年11月13日時点の内容です。
- Anthropic 「インターリーブ思考により、Claudeはツール呼び出しの間に思考し、各ツールの結果について推論してから行動できます。」adaptive thinkingに対応するモデルでは自動的に有効になります。手動のextended thinkingを使うモデルではベータヘッダーが必要です。
- OpenAI gpt-5.5などのモデルは「インターリーブ思考に対応しており、思考の前や思考の合間に可視の出力トークンを生成でき、ツール呼び出しの間にも思考できます」。
- Google Geminiの思考に関するページではこの用語は使われていません。思考ステップは「関数呼び出し、ユーザー入力、モデル出力と並んで時系列に現れる」とし、thought signaturesは「マルチターンのやり取りにわたって推論の連続性を維持するために必要」だと説明しています。
- vLLM オープンソースの推論サーバーであるvLLMは、2つのモデルシリーズでインターリーブ思考に対応しており、それが「トークン使用量と応答レイテンシを増加させる」と注意喚起しています。
研究分野では、Xieら(2025)がモデルを「思考と回答をインターリーブする」ように訓練し、最初のトークンまでの時間が平均で80%以上短縮されたと報告しています。Liangら(2025)はインターリーブ推論を「思考と中間応答の提示を交互に行う」モデルと定義し、計画先行型のバリエーションであるPlantainにより最初の応答までの時間が60%以上短縮されたと報告しています。いずれもテキストタスクを対象とした研究です。
なぜ思考先行型の推論は電話で無音を生むのか?
電話では、モデルが返答の最初の言葉を生成するまで音声合成を開始できません。その言葉より前に生成される推論トークンはすべて、発信者が何も聞こえない時間になります。チャット画面であれば同じ待ち時間も進行状況のインジケーターで済みますが、通話では無音(デッドエア)となり、レイテンシが増加します。
Retellのレイテンシのトラブルシューティングに関するドキュメントでは、大規模で推論重視のモデルは「最初のトークンまでが遅く」、「性能と引き換えにレイテンシを犠牲にする」と説明しています。OpenAIは、reasoning effortをnoneに設定して実行する一般的なユースケースとして音声を挙げ、レイテンシが重要なアプリケーションでは「より深い推論に進む前に、短い前置きを生成するようモデルに指示する」ことを推奨しています。モデルの選び方については、AI音声エージェントに最適なLLMのガイドで解説しています。
音声エージェントにおけるインターリーブ推論とは?
音声エージェントにおけるインターリーブ推論とは、モデルが返答の最初の文をすぐに書き出し、その文が話されている間に無音で推論し、その推論に基づいて返答を続けることを指します。発信者には途切れのない1つの回答として聞こえ、推論の内容が読み上げられることはありません。
Tell-1はこの方式で動作します。Retellの技術記事Retell LLM: Interleaved Reasoning for Real-Time Voice Agentsでは、この形式を「話し出しの一文、次に推論、そして返答の残り」と説明しています。同記事によると、返答の途中で生成される推論トークンは平均200で、99.98%のターンで最初の文の後の間(ま)が400ms未満に収まっています。
思考先行型の推論と比べ、発信者は推論が終わるまで無音で待つ必要がありません。同記事ではトレードオフについても、「早く話し始めるということは、推論が行われる前に話し出しの一文を確定させることを意味する」と述べています。Tell-1はRetell vCX Benchmarkで総合1位を獲得しています(2026年11月時点)。
インターリーブ推論に関するよくある質問
インターリーブ推論とインターリーブ思考は同じものですか?
多くの場合、同じ意味で使われます。AnthropicとOpenAIはインターリーブ思考(interleaved thinking)と呼び、研究論文ではインターリーブ推論(interleaved reasoning)と呼ぶ傾向があります。
推論トークンは課金されますか?
はい。OpenAI、Anthropic、Googleはいずれも、推論トークンを課金対象の出力としてカウントします。OpenAIとAnthropicは、推論テキストが返されない場合でも課金します。
モデルの推論トークンを読むことはできますか?
通常はできません。OpenAIとAnthropicは、リクエストすれば要約を返すことができます。どちらも生の推論は返しません。
インターリーブ推論によってモデルの応答は速くなりますか?
それ自体で速くなるわけではありません。ツール呼び出しの間ではトークンが増え、vLLMのドキュメントも応答レイテンシが増加すると注意喚起しています。最初の可視出力が早く届くのは、可視出力が推論より前に来る場合、または短く分割された推論ブロックの間に来る場合に限られます。
音声AIにおけるインターリーブ推論とは何ですか?
すぐに話し始め、最初の文が再生されている間に無音で推論し、その推論を使って返答を完了させるモデルのことです。Retell独自のLLMであるTell-1は、この方式で構築されています。
推論モデルをライブ通話で運用する
Retell AI は、コンタクトセンター向けのAI音声エージェントプラットフォームです。各エージェントの基盤となるモデルを自由に選択できます。Tell-1もその選択肢の一つです。Retellチームに問い合わせる
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


