SSML(Speech Synthesis Markup Language:音声合成マークアップ言語)は、テキスト読み上げ(TTS)エンジンに対してテキストの読み上げ方を指示するXMLベースのマークアップ言語です。どこで間を置くか、単語をどう発音するか、数字や日付をどう読むか、どのくらいの速さ・音量・高さで話すかを指定できます。エンジンはタグを指示として解釈し、タグ自体は読み上げません。
SSMLはWorld Wide Web Consortium(W3C)の標準規格です。現行バージョンのSSML 1.1は2010年9月7日にW3C勧告となったもので、W3CのVoice Browser Working Groupが策定しました。仕様書では、その目的を「さまざまな音声合成対応プラットフォームにわたって、発音、音量、ピッチ、速度などの音声の要素を制御するための標準的な方法」を作成者に提供することだと述べています。
SSMLはどのような形式ですか?
SSMLドキュメントは、ルート要素<speak>を1つだけ持つXMLです。次の短い例は有効なSSML 1.1です:
<speak version="1.1" xmlns="http://www.w3.org/2001/10/synthesis" xml:lang="en-US">
  Your code is <say-as interpret-as="characters">B7X4</say-as>.
  <break time="400ms"/>
  It ships to <phoneme alphabet="ipa" ph="ˌmænɪˈtoʊbə">Manitoba</phoneme>
  on <say-as interpret-as="date" format="yyyymmdd" detail="1">2026-11-19</say-as>.
  Questions go to <sub alias="Doctor">Dr.</sub> Lee.
</speak>
下図は、エンジンが各タグに対応している場合に、リスナーに聞こえる内容を示しています。
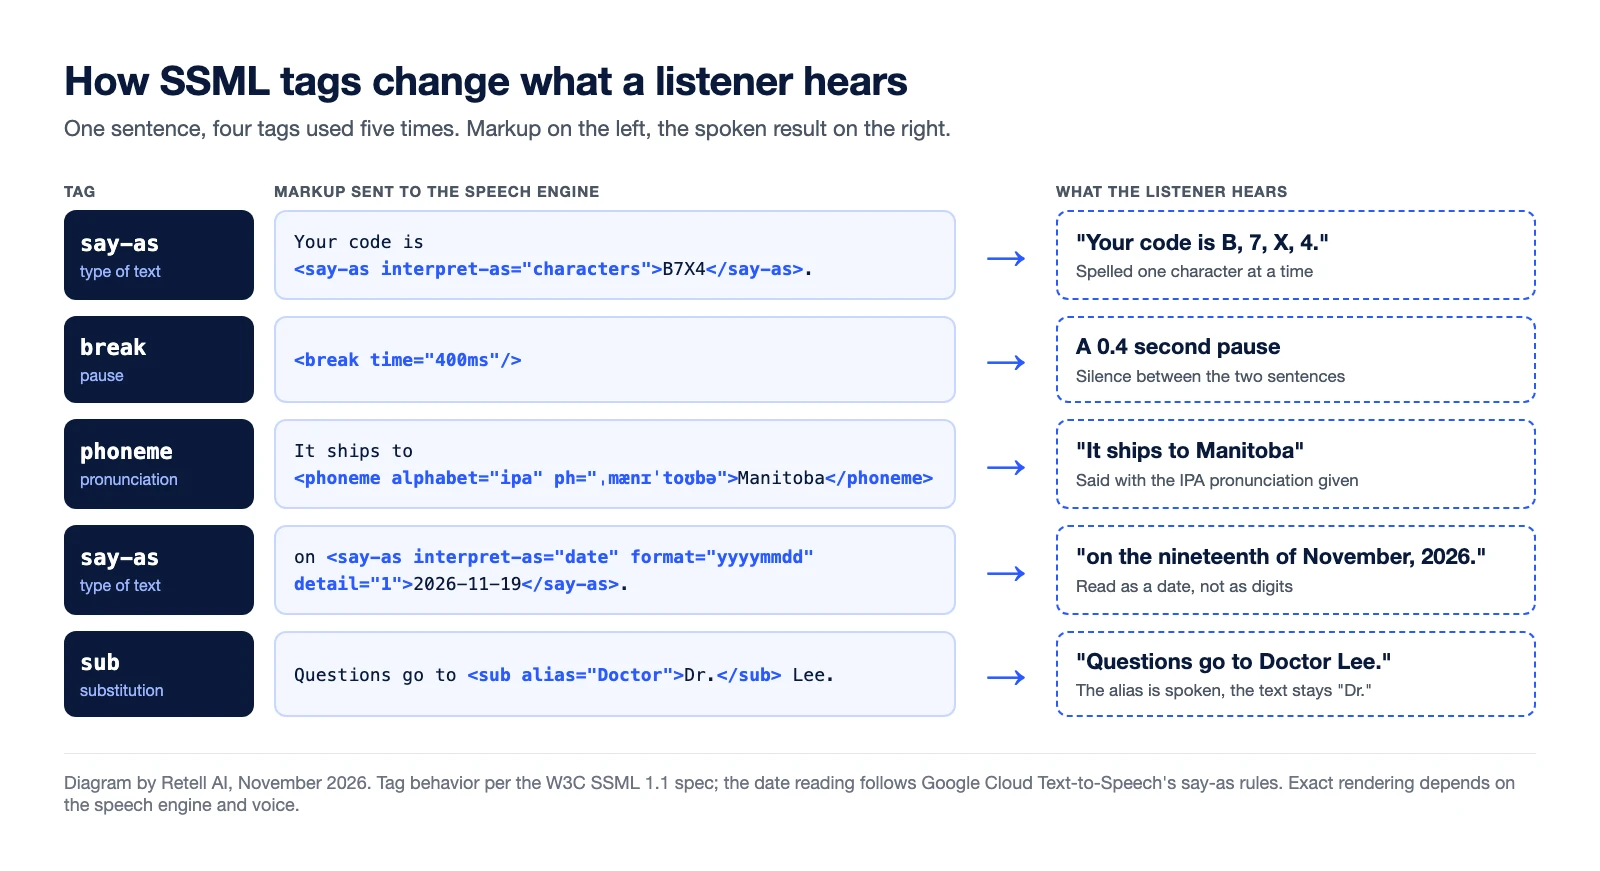
最もよく使われるSSMLタグは?
説明はW3C仕様に基づいています。
| タグ | 機能 | 例 |
|---|---|---|
<speak> | すべてのSSMLドキュメントのルート要素です。SSML 1.1では、version属性とxml:lang属性、およびSSML名前空間が必須です。 | <speak version="1.1" xml:lang="en-US"> |
<break> | strength(noneからx-strongまで)またはtimeで指定した、間(ポーズ)や韻律上の区切りを追加します。 | <break time="400ms"/> |
<say-as> | 日付、時刻、数値、金額など、読み上げるテキストの種類をエンジンに伝えます。 | <say-as interpret-as="characters">B7X4</say-as> |
<phoneme> | 囲んだテキストの発音を音声表記で指定します。仕様では、エンジンはipaアルファベットに対応すべきとされています。 | <phoneme alphabet="ipa" ph="..."> |
<sub> | 書かれたテキストの代わりにaliasの値を読み上げます。 | <sub alias="Doctor">Dr.</sub> |
<prosody> | 囲んだテキストのピッチ、話す速度、音量を変更します。 | <prosody rate="slow"> |
<emphasis> | 単語やフレーズに強勢を置くよう指示します。levelにはstrong、moderate、none、reducedを指定します。 | <emphasis level="strong"> |
仕様にある2つの点が、結果にばらつきが出る理由を説明しています。1つ目に、仕様は<say-as>を定義していますが「属性に指定可能な値を列挙していない」ため、interpret-asの値の一覧は各ベンダーが独自に定めています。2つ目に、prosodyの値は「目安(indicative)」とされ、強調の表現方法はエンジンの判断に委ねられています。
音声エンジン間でSSMLのサポートはどこが違うのですか?
各エンジンは独自のサブセットを実装しており、新しい音声モデルほど対応するマークアップが少ないことも珍しくありません。2026年11月13日時点の各ベンダーのドキュメントによると:
- Google Cloud Text-to-Speechは「利用可能なSSMLタグのサブセット」をサポートしています。Chirp 3: HDボイスは
<emphasis>を除く10種類のタグを受け付け、それ以外のタグは「無視され」、ストリーミングリクエストではSSMLを使用できません。 - Amazon Pollyはボイスタイプ別のタグサポートを公開しています。
<emphasis>はニューラル、ロングフォーム、生成AIボイスでは使用できず、スタンダード、ニューラル、ロングフォームの各ボイスで未対応のタグを使うとエラーが返されます。 - Azure AI SpeechはSSML 1.0をベースに実装しており、サポートされる要素は「W3C標準と異なる場合がある」としています。話し方のスタイル用に独自の
mstts要素を追加しており、単語レベルの強調は特定の英語ボイス3種類でのみ機能します。 - ElevenLabsは一部のモデルで2種類のSSMLタグをサポートしています。最大3秒の間を入れる
<break>と、Flash v2でのみ使える<phoneme>です。Eleven v3とv4はbreakタグに対応していません。 - Cartesia Sonicは独自の「SSML風」タグ(speed、volume、emotion、break、spell)をドキュメント化しています。
同じドキュメントでも、あるエンジンでは反映され、別のエンジンでは何の通知もなく無視され、さらに別のエンジンでは拒否されることがあります。マークアップは、実際に運用するボイスとモデルそのものでテストしてください。
音声エージェントにとってSSMLが重要な理由は?
電話の相手にはテキストが見えません。音声AIでは、読み間違い1つで聞き返しや誤った記録が発生します:
- 名前。ボイスが誤って推測しがちなブランド名、薬品名、姓の発音。
- 数字。確認コードが1つの単語として読まれたり、口座番号が数量として読まれたりする。
- 日付と時刻。11/19のような日付が2つの別々の数字として読まれる。
- 間(ポーズ)。電話番号の区切りごとに書き留めるための時間。
SSMLは、開発者が各行に一度タグを付ければ済む、スクリプト化されたプロンプトに適しています。IVRのメニューには向いていますが、リアルタイムで会話するAI音声エージェントにはあまり向いていません。
LLM駆動の音声エージェントは、SSMLを使わずにどう発音を制御するのですか?
LLM駆動のエージェントでは、大規模言語モデルが通話中に各応答を生成し、テキストは生成と同時に音声エンジンへストリーミングされます(STT、LLM、TTSパイプラインの仕組み)。手作業で文にタグを付ける人はおらず、さらにストリーミングには落とし穴があります。Cartesiaのドキュメントでは、ストリーミングされるトークンをまたいで分割されたspeedやvolumeのタグは、そのまま読み上げられてしまうと注意喚起しています。そのため、チームは代わりに次の4つの方法を使います:
- 読み上げやすいテキストをプロンプトで指示する。「415」の代わりに「four one five」と書くようモデルに指示します。
- テキスト正規化。音声合成の前段の処理で、数字、日付、通貨を読み上げ用の形式に変換します。
- 発音辞書。音声表記付きの単語リストを、すべての応答に適用します。
- プラットフォームの音声制御。プラットフォームが各ボイスプロバイダー向けに変換するインラインマーカーです。
Retell AIは間と発音をどのように扱っていますか?
Retell AIのドキュメントには、生のSSML入力に関する記載はありません。代わりに、次の制御機能が記載されています:
- 間とスペル読み。音声制御のドキュメントによると、前後にスペースを入れたダッシュで間が追加され、
<spell>タグを使うとコードや口座番号を1文字ずつ読み上げます。Retellはこのタグを「エージェントのボイスに最適な形式に」変換します。 - 発音辞書。エントリには、単語と、IPA、CMU、Pinyin、Jyutpingのいずれかで表記した音素を指定します。RetellプラットフォームのボイスはIPAとCMUに対応しており、一部のプロバイダーモデルはいずれにも対応していません。
- Speech Normalization。デフォルトではオフになっているAgent Handbookのプリセットで、数字、日付、金額、電話番号を読み上げ用の形式に整形します。
あわせてAI音声エージェントが通話中にどのように動作するかもご覧ください。
SSMLに関するよくある質問
SSMLは何に使われますか?
テキスト読み上げエンジンがテキストをどのように読み上げるかを制御します。間、発音、数字や日付の読み方、ピッチ、速度、音量などです。
SSMLはどのテキスト読み上げエンジンでも同じですか?
いいえ。各エンジンはW3C仕様の独自のサブセットをサポートし、独自のタグも追加しているため、エンジンを切り替える際にはマークアップの修正が必要になることがよくあります。
ElevenLabsはSSMLに対応していますか?
一部対応しています。ドキュメントには、最大3秒の間を入れるbreakタグと、Flash v2モデルで使えるphonemeタグが記載されています。Eleven v3とv4はbreakタグに対応していません(2026年11月時点)。
SSMLと発音辞書の違いは何ですか?
SSMLタグは1つのテキストの中に記述され、その箇所にのみ適用されます。発音辞書は独立した単語リストで、エンジンやプラットフォームが一致するすべての単語に適用します。
AI音声エージェントはSSMLを使いますか?
音声エンジンがSSMLを受け付ける場合は、使うものもあります。ただし、応答はリアルタイムで生成され、新しい音声モデルの中にはSSMLをほとんど受け付けないものもあるため、多くはプロンプト、テキスト正規化、発音辞書を活用しています。
すべての名前と数字を正しく読み上げる
Retell AIは、コンタクトセンター向けのAI音声エージェントプラットフォームです。エージェントごとに間、スペル読み、発音を制御し、Web通話テストで結果を確認できます。Retellチームに問い合わせる。
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


