投機的デコーディング(Speculative Decoding)は、大規模言語モデルを高速化する手法です。小さなドラフトモデルが次の数トークンを推測します。大きなモデルはそれらを1回のパスでまとめて検証し、自分でも生成したはずのトークンだけを採用します。
この手法は2本の研究論文に由来します。Google ResearchはFast Inference from Transformers via Speculative Decoding(Leviathan、Kalman、Matias、2022年11月初出)でこの手法を命名しました。DeepMindは、別途独自に開発したバージョンをAccelerating Large Language Model Decoding with Speculative Sampling(Chenら、2023年2月)で発表しました。
なぜ通常のデコーディングは遅いのか?
通常のデコーディングが遅いのは、大規模言語モデルがトークンを1つずつ書き出し、トークンごとにモデル全体を1回実行する必要があるためです。Googleの論文はこれを一文で表しています。「Kトークンのデコードには、モデルをK回逐次実行する必要がある」。
こうしたトークンの多くは予測が容易です。同論文は「難しい言語モデリングタスクには、より効率的なモデルで十分に近似できる簡単なサブタスクが含まれることが多い」と指摘しています。
ドラフトモデルとフルモデルはどのように連携するのか?
2つのモデルはラウンド単位で動作し、各ラウンドは3つのステップで構成されます。
- ドラフト。小さなモデルが短い推測列を1トークンずつ書き出します。Googleの論文ではこれを近似モデル(approximation model)、DeepMindではドラフトモデル(draft model)と呼んでいます。
- 検証。ターゲットモデルと呼ばれる大きなモデルが、推測されたすべての位置を1回のパスで並列にスコアリングします。
- 採用または修正。推測は左から右へ順に採用されます。最初に棄却された推測の位置で大きなモデルが自身のトークンを補い、それ以降の推測は破棄されます。すべての推測が採用された場合は、大きなモデルがさらに1トークンを追加します。
大きなモデルの各パスでは最低1トークン、最大で「推測数+1」トークンが得られるため、通常のデコーディングより多くのパスを必要とすることはありません。
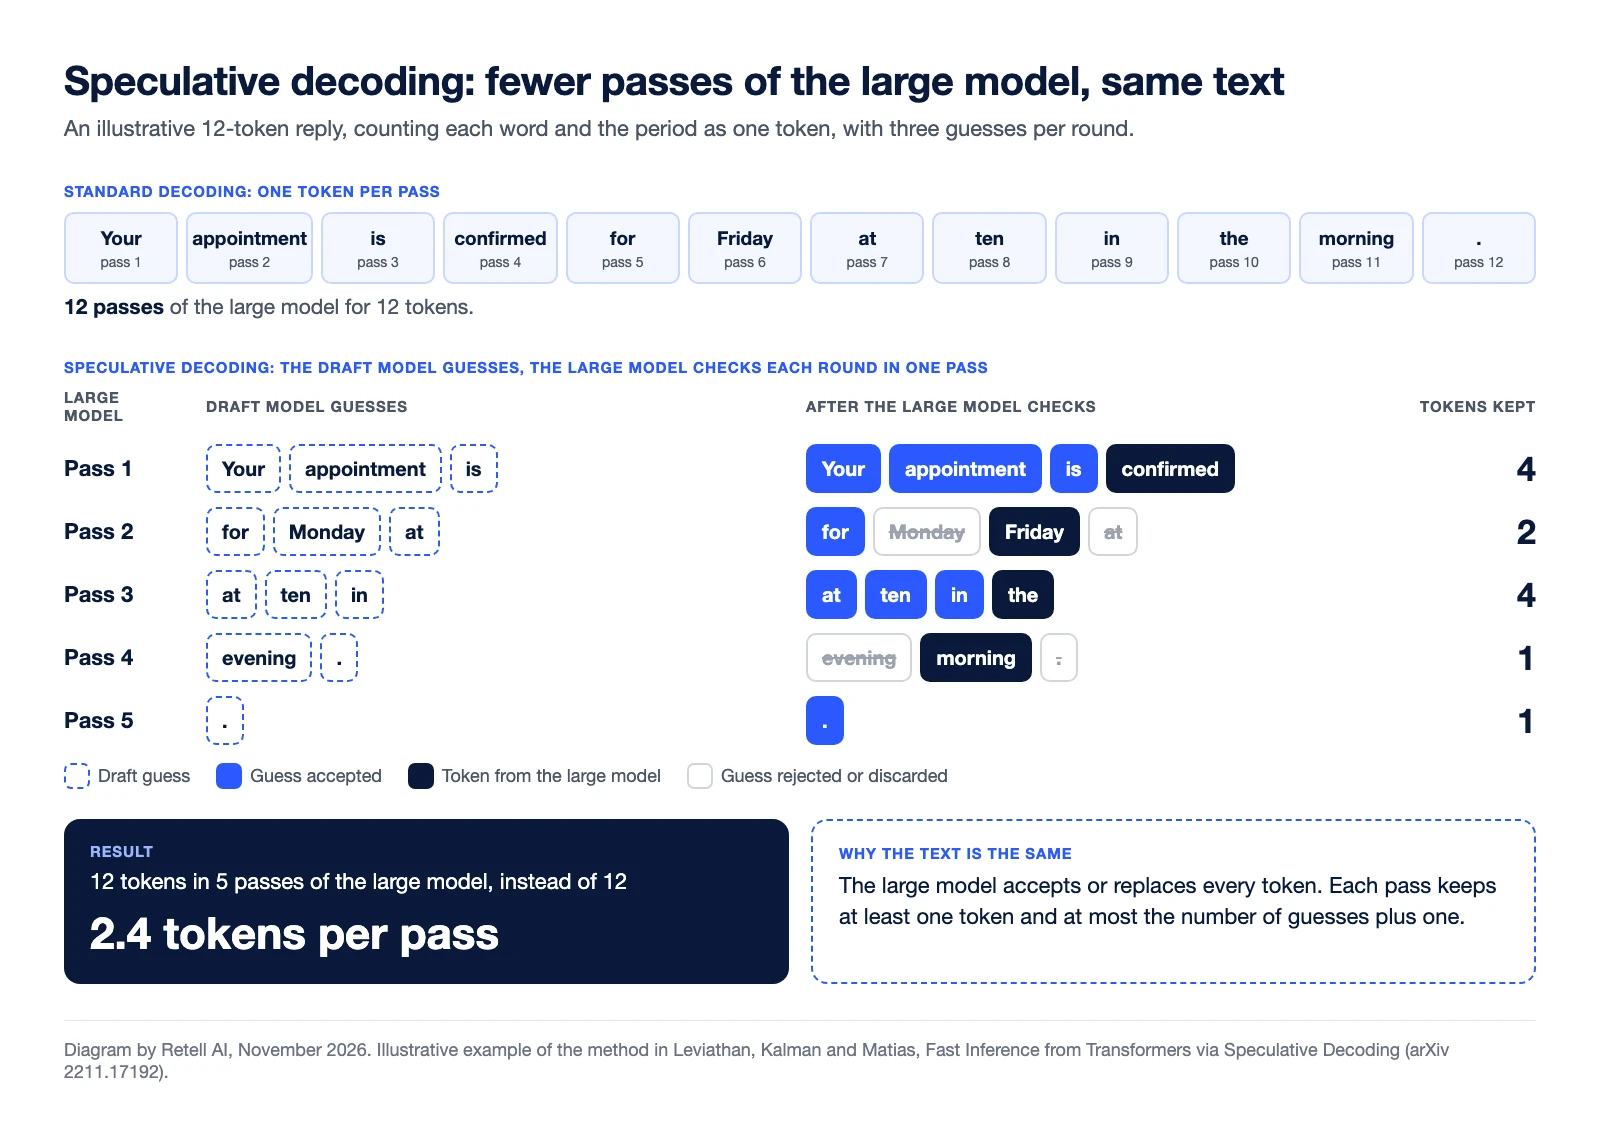
計算例(説明用)。英語の応答「Your appointment is confirmed for Friday at ten in the morning.」を、各単語とピリオドをそれぞれ1トークンとして数えた12トークンとし、1ラウンドあたり3つの推測を行う場合:
| 大きなモデルのパス | ドラフトモデルの推測 | 大きなモデルの判定 | 採用されたトークン数 |
|---|---|---|---|
| 1 | Your appointment is | 3つすべて採用、「confirmed」を追加 | 4 |
| 2 | for Monday at | 「for」は採用。「Monday」は棄却され「Friday」に置換。「at」は破棄 | 2 |
| 3 | at ten in | 3つすべて採用、「the」を追加 | 4 |
| 4 | evening . | 「evening」は棄却され「morning」に置換。ピリオドは破棄 | 1 |
| 5 | . | 採用され、応答が終了 | 1 |
| 合計 | 5パスで12トークン |
通常のデコーディングでは、この文に大きなモデルのパスが12回必要です。ここでは5回の実行で済み、1パスあたり平均2.4トークンとなります。
なぜ出力は変わらないのか?
出力が変わらないのは、すべてのトークンについて大きなモデルが最終決定権を持つためです。モデルが常に最上位の候補を選ぶ貪欲デコーディング(greedy decoding)では、推測は大きなモデルが選んだはずのトークンと一致する場合にのみ採用されます。vLLMのドキュメントには、まさにこれを確認するテストが記載されており、投機的デコーディングを用いた貪欲サンプリングは「用いない場合の貪欲サンプリングと一致する」とされています。
ランダムサンプリングでは、推測は2つのモデルによる評価に基づく確率で採用され、棄却された推測は調整後の分布から再サンプリングされます。Googleの論文は、これによって出力分布が変わらないことを証明しています。DeepMindは、この方式が「ハードウェアの数値精度の範囲内でターゲットモデルの分布を保持する」と表現しています。
一部の新しいバリエーションは、速度を得るために意図的に検証を緩めています。vLLMは、検証方式の1つが「分布を保持しない」と注記しています。
投機的デコーディングが効果を発揮するのはどんなときか?
投機的デコーディングは、ドラフトモデルが低コストで推測がおおむね正しく、サーバーの計算リソースに余裕がある場合に効果を発揮します。
| 条件 | 速度への影響 | 出典 |
|---|---|---|
| 推測がおおむね採用される | 1パスあたりのトークン数が増加。1パスあたりの期待トークン数 = (1 − α^(γ+1)) ÷ (1 − α)。αは採用率、γは1ラウンドあたりの推測数 | Googleの論文 |
| ドラフトモデルがターゲットよりはるかに小さい | ドラフト生成のコストが低い。約2桁小さいドラフトが「通常最も良い結果を示した」 | Googleの論文 |
| 計算リソースに余裕がある | 必須条件。この手法は「増加する並行処理を支えるのに十分な計算リソース」を前提としている | Googleの論文 |
| サーバーのトラフィックが多い | 効果は小さくなる。vLLMはドラフトモデルを、リクエストレートが低い場合は「High gain」、高い場合は「Medium gain」と評価 | vLLMのドキュメント |
| ドラフトがコストに見合わないほど頻繁に外れる | 効果なし。採用率が、ターゲットに対するドラフトの相対コストを上回る場合にのみ高速化が得られる | Googleの論文 |
例として、採用率0.6、1ラウンドあたり3つの推測の場合、1パスあたり約2.2トークンとなります。
公表されている高速化の実績:Googleの論文は、110億パラメータのT5-XXLモデルで2~3倍を報告しています。DeepMindは、700億パラメータのChinchillaと40億パラメータのドラフトの組み合わせで2~2.5倍を報告しています。結果はモデル、タスク、ハードウェアによって異なります。
音声分野での本番環境の例:Retell LLMに関するRetellの技術記事によると、Retell独自のLLMであるTell-1は、投機的デコーディングを用いてフルモデルの1パスあたり約4トークンを得ています。
リアルタイム音声で投機的デコーディングが重要な理由
リアルタイム音声で投機的デコーディングが重要なのは、発信者にとってモデルの処理時間は無音として聞こえるからです。通話では、モデルは音声認識(speech-to-text)、LLM、音声合成(text-to-speech)のパイプラインの1段階であり、その遅延は通話のレイテンシに加算されます。
RetellのカスタムLLMのベストプラクティスでは、モデル処理時間のどの部分が重要かを説明しています。Retellは「最初の完全な文が届いた時点で話し始める」ため、注目すべき数値は「最初のトークンまでの時間に、その最初の文を完成させる時間を加えたもの」です。投機的デコーディングが作用するのは後者で、生成が始まるとトークンがまとまって届きます。最初のトークンより前に行われるプロンプトの読み込みは短縮されません。これについては、Retellのレイテンシのトラブルシューティングガイドが、まずモデルの選択とプロンプトの長さから見直すよう案内しています。
もう1つの理由は精度です。より小さなモデルに切り替えても遅延は減りますが、同ガイドはモデルの切り替えが「速度だけでなく、エージェントの振る舞いも変える」と警告しています。厳密な投機的デコーディングであれば、大きなモデルの出力はそのまま保たれます。
投機的デコーディングはモデルを提供する側が適用するため、エージェントの構築者にとってはモデルの速度として現れます。Retellでは、Tell-1がこの方式で提供されています。速度と通話品質でモデルを比較するには、AI音声エージェントに最適なLLMをご覧ください。
投機的デコーディングに関するよくある質問
投機的デコーディングはロスレスですか?
厳密な形式であれば、はい。元の論文は出力分布が大きなモデルのものと一致することを証明しており、vLLMは「ハードウェアの数値精度の限界まで理論的にロスレス」と説明しています。検証を緩めたバリエーションはロスレスではありません。
投機的デコーディングを考案したのは誰ですか?
Google ResearchのYaniv Leviathan、Matan Kalman、Yossi Matiasが2022年11月に論文を公開し、ICML 2023で発表しました。DeepMindのチームは、投機的サンプリング(speculative sampling)と呼ぶ独自のバージョンを2023年2月に発表しました。
ドラフトモデルとは何ですか?
ドラフトモデルとは、推測を書き出す小型で高速なモデルです。Hugging Faceのドキュメントによると、この手法はドラフトモデルが「メインモデルよりも大幅に小さく、同じトークナイザーを使用する」場合に最も効果を発揮します。
投機的デコーディングでコストは削減できますか?
どちらにもなり得ます。Googleの論文は、棄却された推測は無駄な処理になるため、算術演算の総数が「通常のデコーディングアルゴリズムより多くなる可能性がある」と指摘しています。一方、Googleによる2024年の振り返り記事は、同じハードウェアでより速く結果が得られれば「同じ量のトラフィックを処理するのに必要なマシンが少なくて済む」と補足しています。
マルチトークン予測は投機的デコーディングと同じですか?
いいえ。マルチトークン予測(MTP)は推測を生成する方法の1つです。vLLMのドキュメントでは、MTPはドラフトモデルと並ぶ投機手法の1つとして挙げられています。
実際の通話でモデルの速度をテストする
Retell AIは、コンタクトセンター向けのAI音声エージェントプラットフォームです。実際の通話でのパイロット導入については、Retellチームにお問い合わせください。
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


