プロンプトキャッシングとは、大規模言語モデルがすでに行った処理を省略できるようにする技術です。新しいリクエストが以前のリクエストと同じトークンで始まる場合、モデルはその共通部分について保存済みの計算結果を再利用し、新しい部分だけを処理します。その結果、最初のトークンが速く返され、多くのAPIでは再利用されたトークンの料金も安くなります。
再利用される部分はプレフィックスと呼ばれます。OpenAIのガイドでは、これを「プロンプトの先頭にある変更されていないトークン」と定義しています。通常、指示、ツール定義、それまでの会話のターンがここに含まれます。
プロンプトキャッシングの仕組み
Anthropicのドキュメントでは、処理の流れを次のように説明しています。システムはまず、プロンプトのプレフィックスが最近のクエリですでにキャッシュされているかを確認します。キャッシュされていればそれを使用し、されていなければプロンプト全体を処理してプレフィックスをキャッシュします。
この設計から、次の3つのルールが導かれます。
- 完全一致が必要です。Anthropicは、キャッシュヒットには「100%同一のプロンプトセグメント」が必要だと明記しています。プロンプトの前半で1文字でも変わると、それ以降はすべて再処理されます。
- 順序が重要です。変わらない内容を先に、変わる内容を最後に配置します。
- エントリには有効期限があります。Anthropicのデフォルトのキャッシュ有効期間は5分で、キャッシュされた内容が使われるたびに更新されます。OpenAIの有効期間はモデルによって異なります。
プロンプトキャッシング、プレフィックスキャッシング、KVキャッシュの関係
これらは同じ考え方の3つの層です。KVキャッシュはデータそのもの、プレフィックスキャッシングはそのデータをリクエスト間で再利用すること、プロンプトキャッシングはAPIプロバイダーがこの機能に付けている名称です。
| 用語 | 内容 | 範囲 | 使われる場面 |
|---|---|---|---|
| KVキャッシュ | モデルが読み込んだ各トークンについて計算したキーとバリューの状態。新しいトークンごとに再計算しないよう保持される | 1つのリクエスト内 | モデル内部、推論エンジン |
| プレフィックスキャッシング | リクエスト終了後もKVキャッシュを保持し、同じトークンで始まる後続のリクエストで再利用すること | 同一サーバー上のリクエスト間 | vLLMなどの推論エンジン |
| プロンプトキャッシング | API機能として提供されるプレフィックスキャッシング。有効期間、最小長、料金に関するルールがある | API呼び出し間 | モデルプロバイダーのドキュメントや料金ページ |
Hugging Faceの解説記事は、KVキャッシュを簡潔に「すべてを一から再計算する代わりに、モデルはすでに計算したものを再利用する」と説明しています。vLLMのドキュメントによると、同エンジンの自動プレフィックスキャッシングは「既存のクエリのKVキャッシュをキャッシュし、新しいクエリが同じプレフィックスを共有する場合にそのKVキャッシュを直接再利用できるようにする」ものです。OpenAIもAPI側からこの関係を認めています。「プロンプトキャッシュが保存するのはキー・バリュー(KV)テンソルであり、トークンそのものではありません。」
複数ターンの電話でプロンプトキャッシングが重要な理由
音声エージェントはターンごとにモデルを1回呼び出し、各リクエストには指示、ツール定義、それまでの会話が含まれます。マルチターン会話では、その大部分が前のターンのリクエストと同一で、新しいのは直近のやり取りだけです。キャッシングがなければ、モデルはターンごとに同じ指示を読み直すことになります。
計算例(数値は説明用)。エージェントには2,500トークンの指示とツールがあり、各ターンで会話が100トークン増え、2ターン目以降はすべてプレフィックスがキャッシュにヒットするとします。
| ターン | プロンプトのトークン数 | キャッシュから再利用 | 新たに読み込むトークン |
|---|---|---|---|
| 1 | 2,600 | 0 | 2,600 |
| 2 | 2,700 | 2,600 | 100 |
| 5 | 3,000 | 2,900 | 100 |
| 10 | 3,500 | 3,400 | 100 |
| 全10ターン | 30,500 | 27,000 | 3,500 |
通話全体では、プロンプトの30,500トークンのうち27,000トークン(約89%)がキャッシュから供給されます。2ターン目以降、モデルが読み込むのは2,600トークン以上ではなく、新しい100トークンだけです。
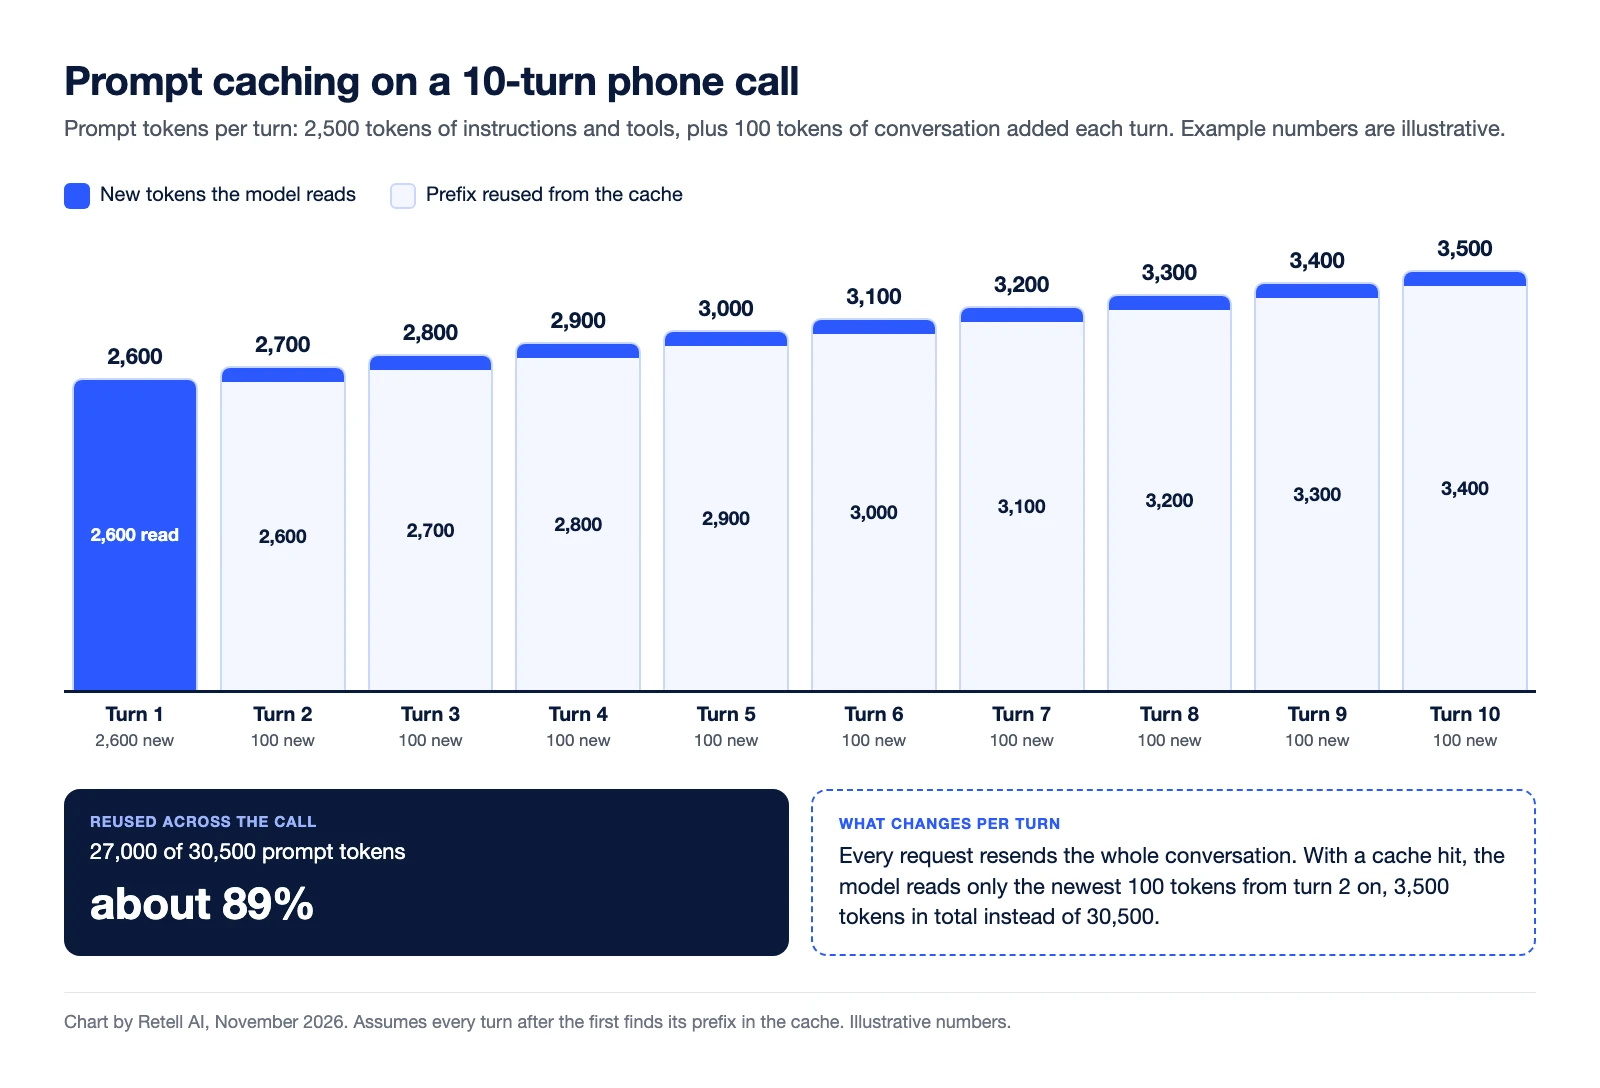
これが重要な理由は2つあります。1つ目は、最初のトークンまでの時間が、発信者に無音として聞こえるレイテンシ(遅延)の一部であり、長いプロンプトの読み込みには時間がかかることです。2つ目はコストです。Anthropicはキャッシュ読み取りを基本入力トークン価格の0.1倍、5分間の有効期間でのキャッシュ書き込みを1.25倍に設定しています。
キャッシュヒットを妨げる要因
- プレフィックスの変更。プロンプトの冒頭付近にあるタイムスタンプ、発信者の名前、ツールリストの並び替えは、それ以降のすべてのトークンを変えてしまいます。
- キャッシュの有効期間を超える間隔。
- リクエストが別のマシンに届くこと。OpenAIのガイドは、「キャッシュされた状態は個々のマシン上に存在する」こと、そしてリクエストがプレフィックスを再利用できるのは「有効期限切れでない一致エントリを保持するマシンに届いた場合のみ」であることを指摘しています。
この最後の課題はルーティングで解消できます。Retell独自のLLMであるTell-1は、セッションアフィニティを使い、各通話をすでにキャッシュを保持しているGPU上で処理し続けます。Retell LLMの技術記事によると、これによりキャッシュから供給されるプロンプトトークンの割合が36%から69%へとほぼ倍増し、各ターンで読み込む量が減って応答がより早く始まります。
キャッシングによって回答が変わることはありません。vLLMの設計ノートは、プレフィックスキャッシングは「モデルの出力を変えない」と述べています。
AI音声エージェントにおける位置づけ
Retellのレイテンシのトラブルシューティングガイドは、プロンプトの長さがもたらすコストを率直に述べています。「プロンプト内のすべてのトークンが最初のトークンまでの時間を増やし、そのコストは会話のターンごとに発生します。」
RetellのLLM WebSocketを通じて独自のモデルを接続する場合、各応答リクエストには「通話でこれまでに収集されたライブトランスクリプト全体」が含まれます。プロンプトを構築するのはお客様のサーバーなので、キャッシュの挙動はその構築方法とモデルプロバイダーによって決まります。指示とツールを先頭に置いて変更せず、その後にトランスクリプトを追加してください。1ターンが通過する全体の流れについては、リアルタイム音声AIの仕組みをご覧ください。
プロンプトキャッシングに関するよくある質問
プロンプトキャッシングとKVキャッシュの違いは何ですか?
KVキャッシュは、モデルがトークンを読み込む際に構築・保存するアテンションの状態です。プロンプトキャッシングは、リクエスト終了後もその状態を保持し、同じ冒頭トークンを持つ後続のリクエストで再利用できるようにするものです。
プレフィックスキャッシングとプロンプトキャッシングは同じですか?
仕組みは同じです。プレフィックスキャッシングは推論エンジンで使われる用語で、プロンプトキャッシングはモデルプロバイダーがAPIでこの機能に付けている製品名です。
プロンプトキャッシングでモデルの応答は変わりますか?
いいえ。共通のプレフィックスの再計算を省略するだけです。
プロンプトキャッシュはどのくらい保持されますか?
プロバイダーによって異なります。Anthropicのデフォルトは5分で、使用するたびに更新されます。より高い書き込み料金で1時間のオプションもあります。OpenAIの有効期間はモデルによって異なります。
音声エージェントにとってプロンプトキャッシングが重要なのはなぜですか?
通話の各ターンでは、指示とそれまでの会話が再送されます。キャッシュヒットすれば、モデルが読み込むのは最新のやり取りだけです。
自社の通話でその違いを体感してください
Retell AIは、コンタクトセンター向けのAI音声エージェントプラットフォームです。Tell-1は、電話のために構築された独自のLLMです。ドキュメントでは、すべての通話のレイテンシをコンポーネント別に確認する方法を紹介しており、待ち時間のうちどれだけがモデルによるものかを把握できます。Retellチームに問い合わせる。
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


