最初のトークンまでの時間(TTFT:Time to First Token)とは、大規模言語モデル(LLM)にリクエストを送信してから、その応答の最初のトークンを受信するまでの時間です。モデルが回答を始めるまでの速さを測る指標であり、回答全体にかかる時間ではありません。
NVIDIAのベンチマークガイドでは、TTFTを「クエリの送信から最初のトークンを受信するまでの時間」と定義しています。電話では、TTFTは発信者が体感するレイテンシ(遅延)の一部です。TTFTの上には、さらに2つの指標があります。最初の文までの時間と、エンドツーエンドの音声レイテンシです。
TTFTには何が含まれますか?
TTFTには、モデルが最初のトークンをストリーミングするまでのすべてが含まれます。IBMは4つの要素を挙げています。キューイング遅延、プリフィル時間(プロンプトの処理)、最初のトークンの生成、そしてネットワークとAPIのオーバーヘッドです。
IBMはプリフィルを「多くの場合TTFTの最大の要因であり、特にプロンプトが長い場合に顕著」としています。モデルは何かを書き出す前にプロンプト全体を読み込むため、プロンプトが長いほど待ち時間も長くなります。負荷も影響します。Anyscaleのドキュメントによると、利用が集中しているサーバーでは受信リクエストがキューに入ることがあり、その待ち時間がTTFTに加算されます。
TTFTはどのように測定しますか?
- TTFT = 最初のトークンを受信した時刻 − リクエストを送信した時刻
結果を左右する選択が3つあります。TTFTの数値を示す際は、これらを併記してください。
- 計測地点。クライアント側で測定すると、TTFTにはネットワーク時間が含まれます。モデルサーバー内で測定すると含まれません。
- パーセンタイル。中央値(P50)は典型的なリクエストを示します。P90とP99は遅いリクエストを示します。
- 負荷の大きさ。アイドル状態のサーバーへの単一リクエストは最良のケースです。NVIDIAによると、本番環境では、あるリクエストのプリフィルが別のリクエストの生成と重なることがあります。
電話において、TTFT、最初の文までの時間、エンドツーエンドのレイテンシはどう違いますか?
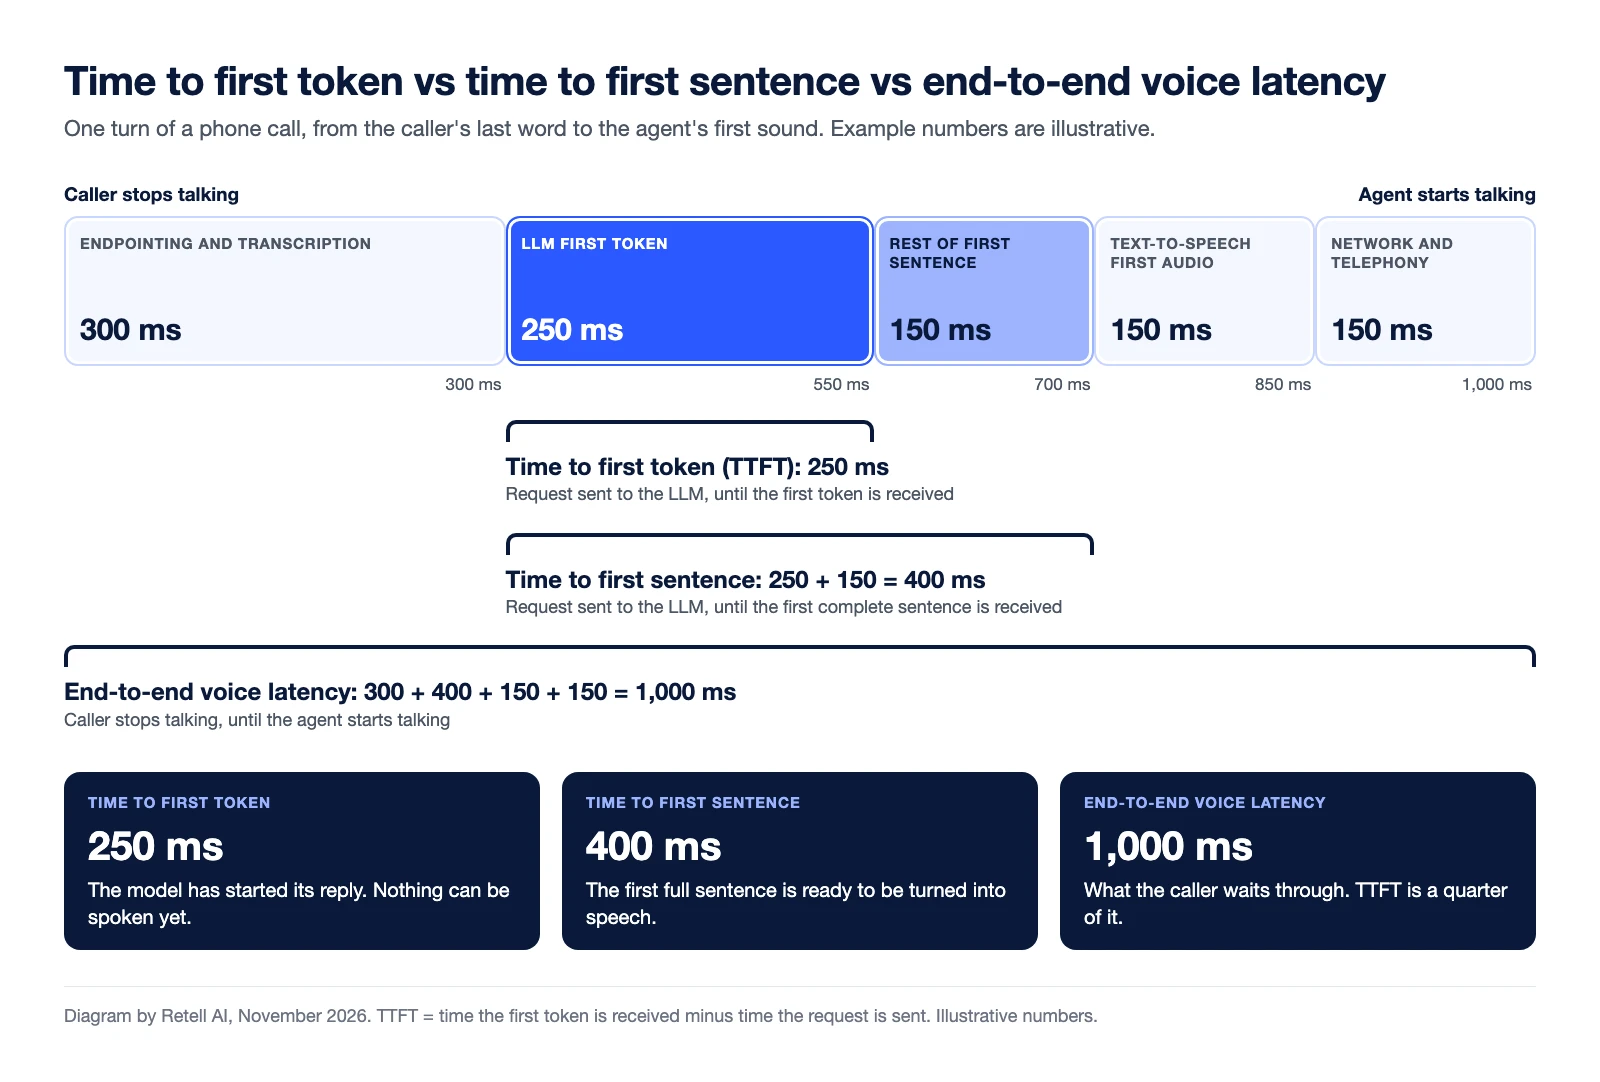
TTFTは最初のトークンの時点で計測が止まります。最初の文までの時間は、完全な1文が届いた時点で止まります。エンドツーエンドの音声レイテンシは、発信者が体感する待ち時間全体をカバーします。
発信者がトークンを聞くことはありません。RetellのカスタムLLMのベストプラクティスには「Retellは最初の完全な文を受け取るとすぐに話し始めます」とあります。そこで重要になる数値は「最初のトークンまでの時間に、その最初の文を完成させるまでの時間を加えたもの」です。
Retellのレイテンシに関するドキュメントでは、エンドツーエンドのレイテンシを「ユーザーが話し終えてから、エージェントが話し始めるまで」として測定しています。
| 指標 | 計測開始 | 計測終了 | 含まれないもの |
|---|---|---|---|
| 最初のトークンまでの時間(TTFT) | LLMへのリクエスト送信 | 最初のトークンの受信 | 最初の文の残り、音声認識、音声合成 |
| 最初の文までの時間 | LLMへのリクエスト送信 | 最初の完全な文の受信 | 音声認識、音声合成、テレフォニー |
| エンドツーエンドの音声レイテンシ | 発信者が話し終える | エージェントが話し始める | パイプライン内では何もなし。発信者までのネットワーク区間が数値に含まれているかを確認してください |
名称に関する注意点:LLMのベンチマークでは、エンドツーエンドのレイテンシは最後のトークンまでを指します。NVIDIAはこれを「クエリの送信から完全な応答を受信するまでにかかる時間」と定義しています。
計算例(数値は説明用)。通話の1ターン:
- エンドポインティングと文字起こし:300 ms
- LLMの最初のトークン:250 ms
- 最初の文の残り:150 ms(追加の15トークン×各10 ms)
- 音声合成(TTS)の最初の音声:150 ms
- ネットワークとテレフォニー:150 ms
TTFTは250 msです。最初の文までの時間は250 + 150 = 400 msです。エンドツーエンドの音声レイテンシは300 + 400 + 150 + 150 = 1,000 msとなり、TTFTは発信者の待ち時間の4分の1を占めます。音声AIのレイテンシベンチマークに関するガイドでも、同じ配分を使用しています。
モデルを比較する際、TTFTが誤解を招くのはなぜですか?
TTFTの数値は、同じ方法で測定した別のTTFTの数値としか比較できません。あるモデルのTTFTを別のモデルの最初の文までの時間と比べると、前者が常に速く見えます。モデル単体の時間と実際の通話で測定した時間を比べる場合や、中央値とP99を比べる場合も同様です。
また、モデルが最初のトークンをすぐに送信しても、その後のストリーミングが遅ければ、発信者は無音のまま待たされることになります。
音声エージェントのTTFTを下げるには?
Retellのレイテンシのトラブルシューティングガイドは、レイテンシが高くなる最も一般的な2つの原因として、モデルの選択とプロンプトの長さを挙げています。
- より高速なモデルを選ぶ。Tell-1は通話向けに構築された選択肢の1つです。ガイドによると、大規模で推論志向のモデルは「最初のトークンまでが遅い」とされています。
- プロンプトを短くする。「プロンプト内のすべてのトークンが最初のトークンまでの時間を増加させます」。これは毎ターン発生します。約8kトークンを超えるプロンプトは、目に見えて遅くなります。
- 応答をストリーミングする。カスタムLLMでは、完全な応答を1つのイベントで送信すると「生成全体が発信者の無音時間に入ってしまいます」。
RetellのGet Call APIは、通話ごとにエンドツーエンド、LLM、音声合成のレイテンシをP50、P90、P95、P99で返します。LLMの数値は「最初の発話可能なチャンクを受信するまで」を計測するため、最初の生のトークンではなく、発話可能なテキストを測定しています。
この指標を軸に設計されたモデルもあります。Retell独自のLLMであるTell-1は、応答を開始し、最初のフレーズが再生されている間も推論を続けます。Retell vCX Benchmarkにおいて76 msと最も低い中央値レイテンシを記録しています(最初の文までの時間の24時間移動中央値、2026年11月13日時点)。Retell LLMの技術ブログ記事で仕組みを解説していますが、モデルの処理時間はエンドツーエンドの音声レイテンシの一部にすぎません。
最初のトークンまでの時間に関するよくある質問
最初のトークンまでの時間はどのくらいが適切ですか?
単一の基準はありません。モデル、プロンプトの長さ、サーバー負荷によって異なります。音声エージェントの場合は、エンドツーエンドの数値の中で評価してください。Retellのドキュメントでは、エージェントの推定レイテンシを1.5秒未満に抑えることを推奨しています。
TTFTはレイテンシと同じですか?
いいえ。TTFTは最初のトークンが出るまでのLLMの遅延です。通話におけるレイテンシは、発信者が話し終えてからエージェントが話し始めるまでの待ち時間全体です。
TTFTにネットワーク時間は含まれますか?
測定する場所によります。NVIDIAによると、TTFTは「一般的にリクエストのキューイング時間、プリフィル時間、ネットワークレイテンシを含む」とされています。サーバー内で測定したモデル単体の数値には、ネットワークは含まれません。
TTFTと最初の文までの時間の違いは何ですか?
TTFTは最初のトークンの時点で計測が止まります。最初の文までの時間は最初の完全な文が届いた時点で止まり、これは音声エージェントが話し始められるタイミングです。
自社の通話でレイテンシを測定する
Retell AIは、コンタクトセンター向けのAI音声エージェントプラットフォームです。Call Historyでは通話ごとのレイテンシを確認でき、Get Call APIではコンポーネント別の内訳を確認できます。Retellチームに問い合わせる。
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


