LLM as a judge(LLM-as-a-Judge)とは、ある大規模言語モデルが、人間のレビュアーに代わって、別のAIシステムの出力を文書化された基準に照らして採点またはランク付けする評価手法です。電話での会話のように唯一の正解がない、自由形式の成果物を評価する際に使われます。
この名称は、2023年の論文Judging LLM-as-a-Judge with MT-Bench and Chatbot Arenaに由来します。著者らは、GPT-4のような強力なジャッジが人間の選好と「80%を超える一致率」を示し、これは「人間同士の一致率と同水準」であると報告しました。同時に、位置バイアス、冗長性バイアス、自己強化バイアスという限界も挙げています。
LLMジャッジは会話をどのように採点するのか?
LLMジャッジは会話と一連の指示を読み込み、次の3つのいずれかの形式で判定を返します。
| 手法 | ジャッジが行うこと | 返される結果 | 適した用途 |
|---|---|---|---|
| ルーブリック採点 | 1件のトランスクリプトを文書化された基準に照らして読む | 合否またはスコアと、その理由 | 本番環境のQAと回帰テスト |
| ペアワイズ比較 | 同じターンに対する2つ以上の応答を比較する | 勝者、またはランキング順 | プロンプトやモデルの選定 |
| ジャッジパネル | 複数のジャッジモデルが同じ項目を採点し、判定を集約する | 集約された1つのスコア | 単一モデルのバイアスで歪みかねないスコア |
ルーブリック採点。G-Evalの論文では、ジャッジに基準を順に推論させたうえで採点フォームを記入させました。要約タスクにおいて、そのスコアは従来の手法よりも人間の評価と高い相関を示しました。
ペアワイズ比較。2つの応答のどちらが優れているかを問う方法は、トーンのように、点数化するよりも違いを見比べる方が容易な品質の評価に適しています。
ジャッジパネル。Replacing Judges with Juriesでは、異なるモデルファミリーの小規模モデルで構成したパネルが「単一の大規模ジャッジを上回り、モデル内バイアスも少なく」、しかも「コストは7分の1以下」でした。
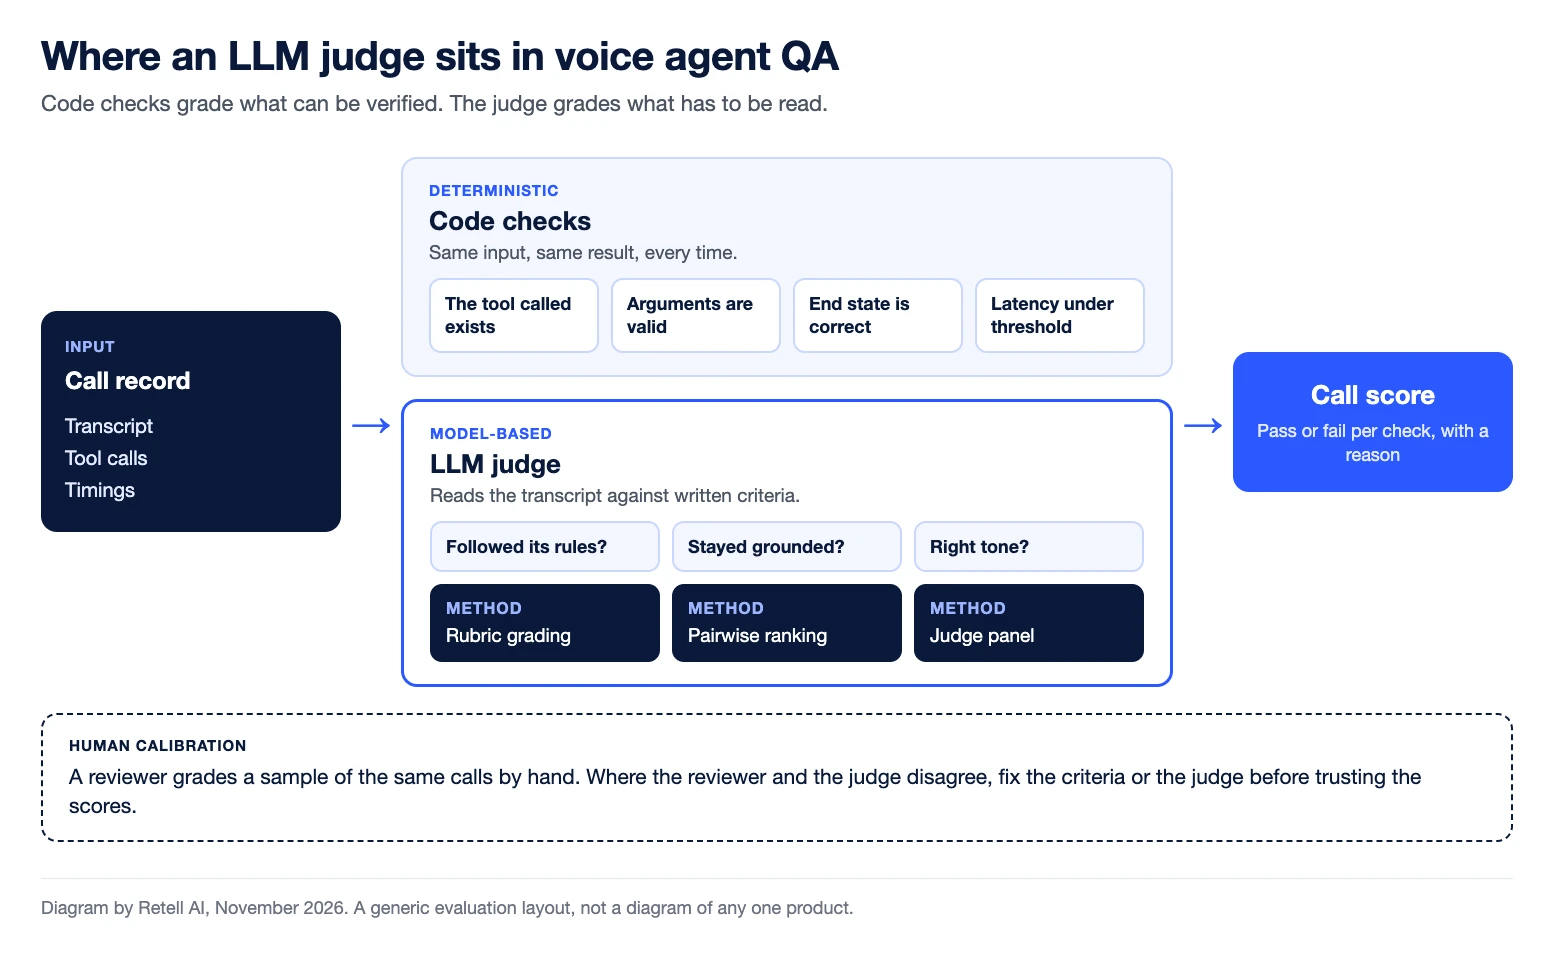
AI音声エージェントのQAやベンチマークでLLM as a judgeはどう使われるのか?
AI音声エージェントのQAでは、トランスクリプトを読まなければ判断できない通話の要素にLLMジャッジを使います。たとえば、エージェントがルールに従ったか、情報源の範囲内で回答したか、リクエストを解決したか、といった点です。
Retellのドキュメントでは、代表的な2つの構成が紹介されています。AI QAでは、AI評価条件は「各通話のトランスクリプトとコンテキストに対してAIが実行する定性的なチェック」であり、「条件が満たされているかをAIが判断するためのプロンプト」として記述します。シミュレーションテストでは、AIが発信者役を務め、「各実行は合否で判定され、説明文が付与されます」。
ベンチマークも同様の判定を大規模に報告します。Retell vCX Benchmarkは、指示への準拠、グラウンディング、ツール呼び出し、口語表現の各スイートのスコアを、「テストしたシナリオのうち正しく処理できた割合」である合格率として公開しています(2026年11月13日閲覧)。
判定結果を週次レビューに活用する方法は、AI音声エージェントのQAスコアカードをご覧ください。
LLMジャッジの既知の失敗パターンとは?
LLMジャッジには、文献で報告されている4つの失敗パターンがあります。それぞれに既知の対策があります。
- 位置バイアス。Large Language Models are not Fair Evaluatorsでは、2つの回答の順序を入れ替えるだけで、一方のモデルが「テストした80件のクエリのうち66件」で勝利しました。比較は必ず両方の順序で実行してください。
- 自己選好。2024年の研究では、評価モデルが「人間のアノテーターが同等の品質とみなす出力であっても、他者の出力より自身の出力を高く採点する」ことが判明しました。異なるモデルファミリーのジャッジ、またはパネルを使用してください。
- 人間との一致度の低さ。Judging the Judgesは13のジャッジモデルをテストし、「人間と妥当な一致を示したのは最も優れた(かつ最大の)モデルのみ」であり、「採点が甘くなる傾向」もあることを明らかにしました。サンプルを手作業で採点して比較してください。
- ドリフト。API の背後にあるモデルは変わる可能性があります。ある研究では、同じタスクにおけるGPT-4の正答率が3か月で84%から51%に低下したことが測定されました。基準も変化します。Who Validates the Validators?はこれを基準ドリフトと呼び、「ユーザーが出力を採点するには基準が必要だが、出力を採点することでユーザーは基準を定義できるようになる」と述べています。ジャッジのバージョンを固定し、変更のたびに手作業でラベル付けした固定セットで再評価してください。
また、ジャッジの結果は決定的ではありません。Retellのシミュレーションに関するドキュメントでは、「シナリオは1回の実行ではなく、複数回の実行における合格率で判断してください」と推奨しています。
コードチェックがLLMジャッジより優れるのはどんな場合か?
答えを読む必要がなく検証できる場合は、常にコードチェックがLLMジャッジより優れています。Anthropicによるエージェント評価のガイドは、「可能な場合は決定的な評価者を、必要な場合にLLM評価者を選ぶ」ことを推奨しています。同ガイドでは、コードベースの評価者は高速・低コスト・客観的・再現可能であり、モデルベースの評価者は非決定的であると整理しています。
通話においては、エージェントが呼び出したツールが存在するか、その引数が有効か、応答時間がしきい値を下回っていたかをコードで確認できます。tau-benchはこの方法で会話全体を評価し、「会話終了時のデータベースの状態を、アノテーションされた目標状態と比較」します。
RetellのAI QAでは両者を分けて扱います。パフォーマンス指標は定量的なしきい値で、AI評価条件は定性的なチェックを担います。それぞれをどこで実行するかについては、AI音声エージェントの変更をテストしてリリースする方法で解説しています。
ジャッジパネルは音声モデルのトレーニングにどう使われるのか?
Retell LLMの技術記事によると、Retell独自のLLMであるTell-1は、3つのトレーニング段階のうち2つでLLMジャッジを使用しました。選好チューニングの段階では、「LLMジャッジのパネルがランク付けした選好ペア」から学習しています。
同記事によると、強化学習の段階では「モデルが8つの応答を生成し、そのすべてが採点されます」。最初にコードが実行され、エージェントのツールボックス外のツール呼び出し、不正な形式の出力、その他の重大なエラーは「ジャッジが確認する前にコードで検出されます」。正確性については、「複数のジャッジモデルがツール呼び出しの正確性、ハルシネーション、指示への準拠を採点し、その判定を1つの報酬シグナルに集約します」。自然さについては、「自然さは点数化するより比較する方が容易」であるため、単一のジャッジが8つの応答すべてを並べてルーブリックに照らしてランク付けします。
これが本ページで説明してきたパターンです。検証可能な項目はコードチェック、正確性はジャッジパネル、トーンはランキングで評価します。
LLM as a judgeに関するよくある質問
LLMジャッジは何をするのですか?
通話のトランスクリプトなどの出力を採点指示とともに読み込み、合否、スコア、または2つの選択肢のどちらが好ましいかという判定を返します。
LLM as a judgeはどの程度信頼できますか?
ジャッジモデルとタスクによって異なります。ある研究では人間の選好と80%を超える一致が確認された一方、別の研究では人間と妥当な一致を示したのは最大規模のジャッジのみでした。まずは手作業で採点した通話とジャッジの結果を照合してください。
ジャッジパネルとは何ですか?
ジャッジパネルとは、複数のジャッジモデルが同じ出力を採点し、その判定を集約する仕組みです。単一モデルのバイアスによる影響を軽減できます。
ルーブリック採点とペアワイズ比較の違いは何ですか?
ルーブリック採点は、1つの出力を文書化された基準に照らして採点します。ペアワイズ比較は、ジャッジに2つの出力を示し、どちらが優れているかを問います。
LLMジャッジは音声通話を採点できますか?
はい、トランスクリプトとツール呼び出しをもとに採点できます。ただし、音声そのものに表れる品質の評価には音声も必要です。Retellのドキュメントでは、Agent Naturalnessは「音声とトランスクリプトの両方を用いて評価される」と説明しています。
スケールする前に、自社の通話を採点しましょう
Retell AIは、コンタクトセンター向けのAI音声エージェントプラットフォームです。AI QAは、設定した条件としきい値に照らして通話のサンプルを評価し、各結果の根拠となるトランスクリプトを提示します。
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


